최종 상태가 맞아도 보상을 주면 안 되는 경우: RL 검증기의 허점
정상 대안 경로와 금지 경로, 실행 사이의 상태 누수를 대조해 검증기를 먼저 시험하는 방법을 설명한다.
행동 경로와 최종 상태를 보상에 연결하기
단일 응답에서 다단계 행동으로
도구를 사용해 여러 단계로 판단하는 에이전트는 최종 응답뿐 아니라 실행 경로도 학습 대상이다. DeepMind의 "Era of Experience"에서 제시하듯 에이전트는 환경에서 얻은 경험과 명확한 성공 조건을 바탕으로 학습한다.
시연을 모방할지 성공 조건으로 학습할지
NVIDIA Nemotron 3 계열 모델은 SFT로 초기 그라운딩을 마친 뒤 RL 정제 단계로 넘어가는 하이브리드 전략을 택했다. 업계 전반에서도 RL 단계에 더 많은 컴퓨팅을 투입하는 추세다.
PPO·DPO·GRPO와 검증 가능한 보상
알고리즘 선택(PPO, DPO, GRPO)과 보상 신호 설계는 구분해야 한다.
DPO는 정적 선호 데이터를 이용해 온라인 RL 루프 없이 정책을 조정한다. 톤이나 스타일 같은 선호 학습과 실제 환경에서 여러 단계로 행동하며 검증하는 과제는 성격이 다르지만, 모든 에이전트 작업에 DPO가 부적합한 것은 아니다.
GRPO는 별도 critic 없이 같은 입력에서 나온 여러 출력의 보상을 상대 비교한다. RLVR 설정에서는 주로 결정론적 검증기를 쓰지만 GRPO 자체가 이를 필수로 요구하지는 않으며, 보상은 이진(0/1)이나 연속 값으로 설계한다.
RLVR(Reinforcement Learning from Verifiable Rewards)은 주관적 채점을 유닛 테스트 통과나 올바른 툴 호출 같은 명시적 검증으로 대체해, 최적화의 중심을 알고리즘에서 환경(environment)으로 옮긴다. 이 관점에서 환경은 학습과 행동 사이의 계약(contract)이 된다.
과제·허용 행동·관측·성공 조건으로 환경 정의하기
환경은 에이전트의 통제 밖에 있는 모든 요소를 가리키며, 수행할 태스크, 허용 행동, 관찰 가능한 세계 상태, 성공 기준, 보상 할당 방식을 포함한다.
Rollout: 환경에서 정책을 실행해 경험을 수집하는 과정이다.
Trajectory: Rollout으로 생성된 상태-행동-보상의 순서 있는 시퀀스다.
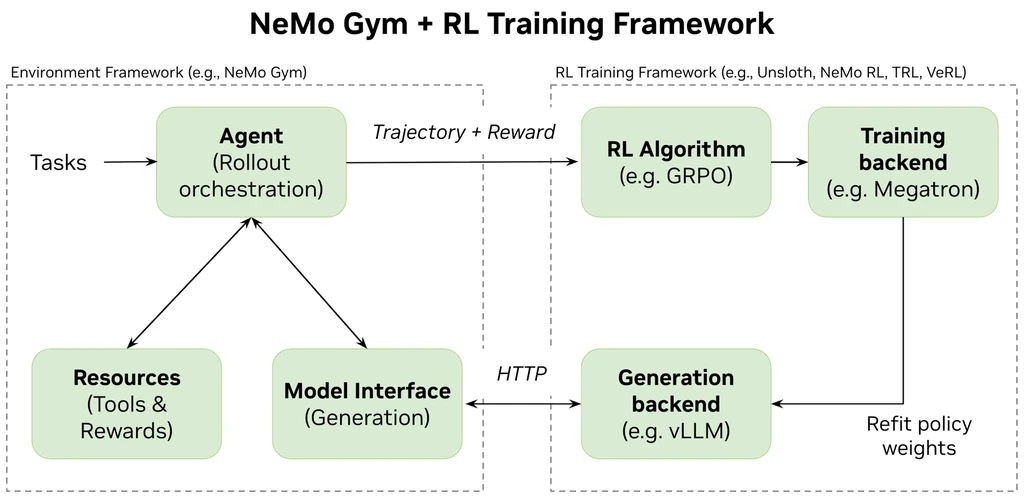
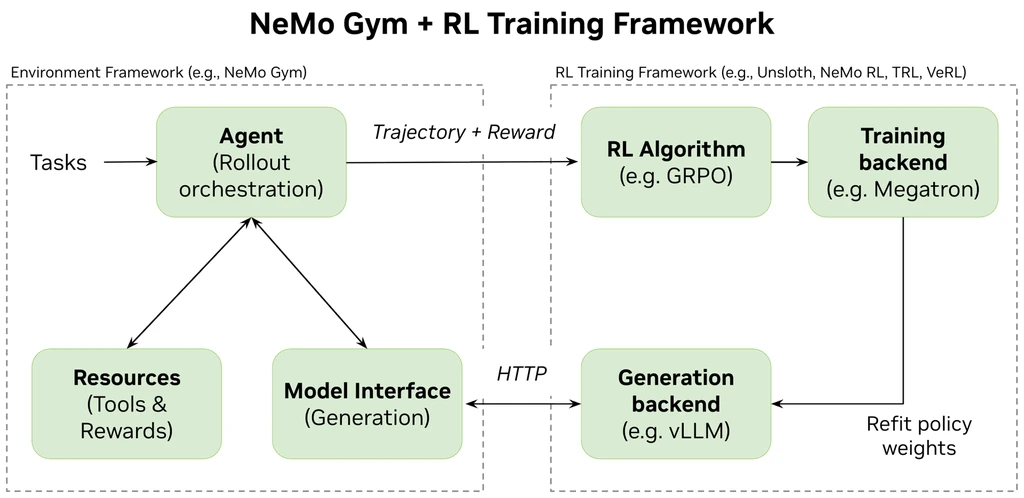
NeMo Gym에서 환경과 학습기 분리하기
NeMo Gym은 훈련 파이프라인에서 환경 로직을 분리하고, OpenAI Responses API로 궤적을 표준화하며, 수천 개의 병렬 환경을 관리한다. Unsloth, NeMo RL, HuggingFace TRL 등 다양한 RL 프레임워크와 호환된다.
환경 준비 뒤 모델 훈련으로 이어지는 2단계
Phase 1(환경 준비)은 벤치마킹 → 역량 정의 → 환경 개발 → 태스크 생성 → 리워드 프로파일링 순으로 진행된다.
Phase 2(모델 훈련)는 환경 준비 단계에서 정의한 '성공 기준' 신호를 최적화하는 과정이다.
태스크와 검증 기준 준비하기
에이전트를 전문화하려면 다양한 시나리오가 필수다. 태스크 특화 데이터가 부족하면 NeMo Data Designer 같은 SDG 도구로 수천 개의 프롬프트를 생성한다. 예를 들어 코딩 환경에서는 LLM으로 Python 문제 5,000개를 만들고, 결정론적 스크립트로 정답 기준이 될 유닛 테스트를 생성한다.
실행 상태와 도구를 환경에 두기
Resources Server는 경량 FastAPI 애플리케이션으로 구현해 툴을 HTTP 엔드포인트로 노출한다. 여러 단계로 진행되는 에이전트 rollout 특성상 session_id를 기준으로 병렬 rollout마다 격리된 상태를 유지한다.
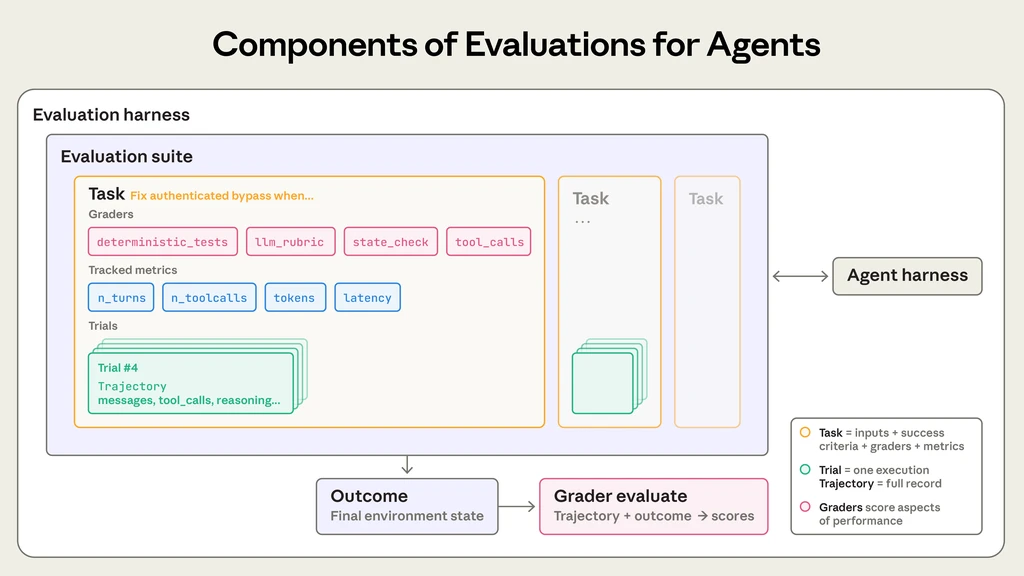
검증기 설계는 크게 두 가지로 나뉜다. Trajectory Matching은 에이전트의 툴 호출 경로를 황금 경로(golden path)와 비교하고, State Matching은 도달 과정과 무관하게 최종 상태를 확인한다. 허용 경로가 여러 개인 작업에는 후자가 적합하지만, 권한 위반이나 금지된 도구 호출을 막아야 한다면 실행 경로도 함께 검사해야 한다.
성공과 실패 기준이 분명한 과제에서는 이진 보상을 우선 검토하고, 대규모 학습에 앞서 작은 모델과 프런티어 모델로 보상 분포를 확인한다. 모델 간 보상 차이가 없다면 과제 난이도나 검증기를 점검해야 한다.
환경 인터페이스를 유지하며 학습기 선택하기
훈련 프레임워크가 환경 구현과 분리되어 있으므로, 환경 로직을 수정하지 않고도 옵티마이저, 스케일링 전략, 하드웨어 백엔드를 교체할 수 있다.
| 구분 | SFT | RL |
|---|---|---|
| 학습 방식 | 시연(demonstration) 모방 | 목표 + 검증 방식 제공 |
| 강점 | 포맷·스타일 교육 | 에지케이스 대응, 추론 경로 탐색 |
| 약점 | 분포 외 시나리오 취약, 미러링 경향 | 검증 함수 설계 난이도 |
| 대표 적용 | 초기 워밍업 | 수학, 코드, 툴 콜링 |
| 컴포넌트 | 역할 |
|---|---|
| Agent Server | 모델 호출, 툴 실행 루프 오케스트레이션 |
| Resources Server | 툴 노출, 세션 상태 유지, 보상 계산 |
| Model Interface | 생성 백엔드와의 표준화된 통신 인터페이스 |
구현 전에 확인할 격리와 검증 계약
실제 구현할 때는 공식 코드와 API 버전을 확인하고 상태 격리와 검증기 동작을 시험해야 한다.
데이터·환경·학습기의 연결
표준 인터페이스로 환경 로직과 학습기를 분리하면, 한쪽을 교체해도 다른 쪽의 책임이 섞이지 않아 확장성을 확보할 수 있다.
Agent Server의 실행·검증 루프
Agent Server는 조건부 루프 구조로 동작한다. responses_loop는 모델 출력이 tool_call이면 Resources Server로 라우팅해 결과를 컨텍스트에 누적하고, text이면 루프를 종료한다. max_steps로 무한 루프를 방지하며, OpenAI Responses API의 대화 스키마를 그대로 따라 표준 툴 스키마와 호환된다.
Resources Server의 세션별 상태
session_id를 키로 삼는 딕셔너리로 상태를 격리해 수천 개의 병렬 rollout을 독립적으로 처리한다. FastAPI로 각 툴을 HTTP 엔드포인트에 노출하고, OpenAI 호환 툴 스키마로 모델의 툴 호출을 처리한다. 세션 초기화(seed_session)와 검증(verify)도 같은 서버에 두어 상태 일관성을 유지한다.
생성한 문제와 테스트도 검토하기
NeMo Data Designer로 자연어 태스크 쿼리를 생성하고 결정론적 스크립트로 정답 기준을 만들면 수동 레이블링 부담을 줄일 수 있다. 단, 생성된 문제와 테스트 자체에 오류가 없는지 검토하는 작업은 여전히 필요하다.
[Task Data / SDG]
       ↓
[NeMo Gym: Agent + Resources + Model Interface]
       ↓ (Rollout Trajectories + Rewards)
[RL Training Framework: Unsloth / NeMo RL / TRL]
       ↓ (Updated Policy)
↑──────────────────────────────────────┘run(task) → seed_session → responses_loop → verify → reward태스크 특성
├─ 경로 자체가 요구사항인가? → Trajectory Matching
├─ 다양한 경로 허용? → State Matching ← 권장
├─ 코드 생성? → Sandboxed Execution (유닛 테스트)
├─ 열린 질문? → LLM-as-a-Judge
└─ 인간 선호 반영? → Reward Model 훈련학습 전에 검증기 시험하기
먼저 정상 풀이와 잘못된 풀이를 같은 환경에서 실행해 보상이 의도대로 나오는지 확인한다. 병렬 세션 간 상태가 섞이지 않는지, 금지된 경로로 얻은 결과가 통과하지 않는지도 검사한다. 예지보전 같은 다른 도메인으로 옮길 때는 보상 해킹과 오검증 사례를 포함해 별도로 평가해야 한다.
가상의 파일 편집 과제에서 “지정 파일의 버전 값을 2로 바꾸되 다른 파일은 건드리지 않는다”를 성공 조건으로 두자. 목표 값만 읽는 검증기는 다른 파일을 삭제한 뒤 2를 기록한 풀이도 통과시킬 수 있다. 반대로 특정 편집 명령 순서만 인정하면 동일한 최종 상태를 만든 정상 대안 풀이까지 거절할 수 있다. 결과 검사와 경로 제약을 함께 정의해야 하는 이유다.
검증용 후보는 정상 풀이, 다른 명령을 쓴 정상 풀이, 목표 파일만 맞추고 다른 파일을 훼손한 풀이, 완료했다고 답했지만 아무것도 바꾸지 않은 풀이로 나눈다. 기대 보상은 앞의 두 경우만 통과하는 것이다. 먼저 이 작은 대조군을 통과시킨 뒤 모델의 보상 분포를 해석해야, 높은 보상이 검증기의 허점 때문인지 구분할 수 있다.
병렬 실행도 같은 기준으로 시험한다. 세션 A가 만든 상태를 세션 B가 읽어 성공으로 채점되면 모델 성능과 상태 누수가 뒤섞인다. 세션별로 초기 상태를 복원하고, 종료 후 남은 파일이나 캐시가 다음 실행에 영향을 주지 않는지 확인한다. session_id 필드가 있다는 사실만으로 격리가 구현됐다고 단정하지 않는다.
참고 자료
What are RL environments and how to build them — Unsloth (https://www.unsloth.ai/blog/rl-environments (새 창))