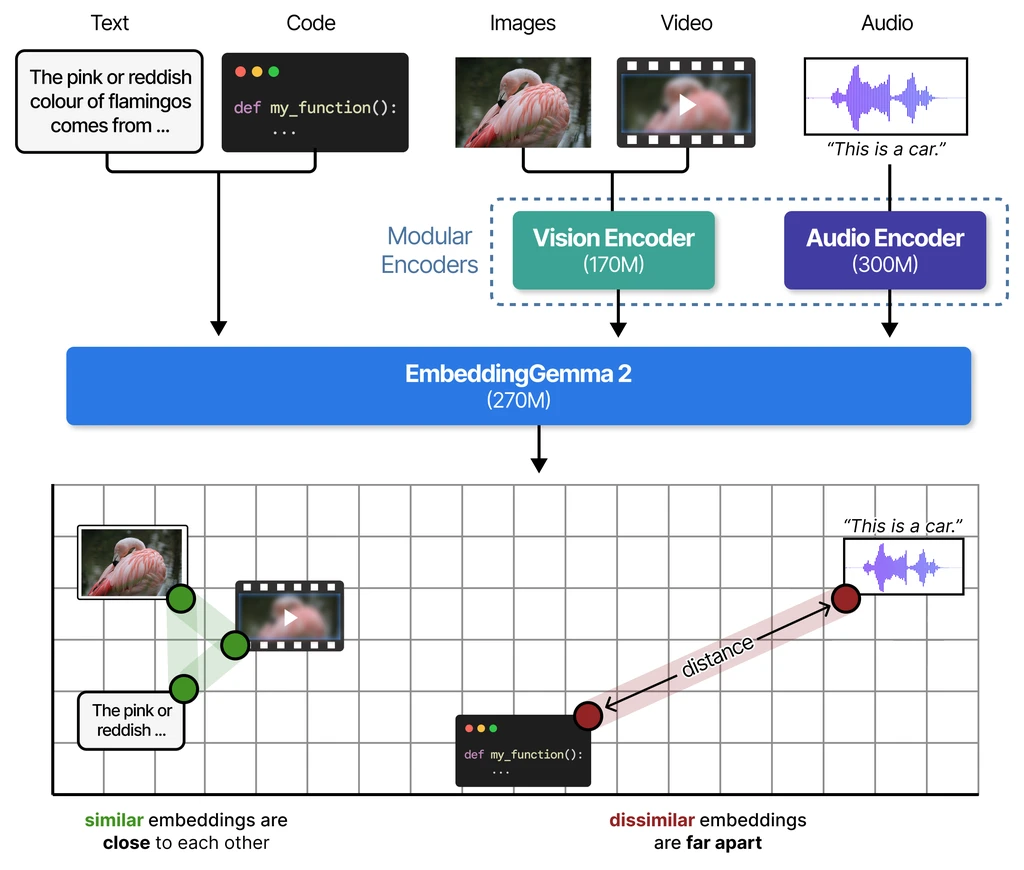
EmbeddingGemma 2 검색이 어긋날 때: 접두어가 바꾸는 입력과 색인
질문과 문서는 다른 접두어로 인코딩된다. 같은 휴가 질문을 따라가며 접두어 중복, 코사인 대칭성, 질문 설정만 바꿔도 되는 경우와 문서 재색인이 필요한 경우를 구분한다.
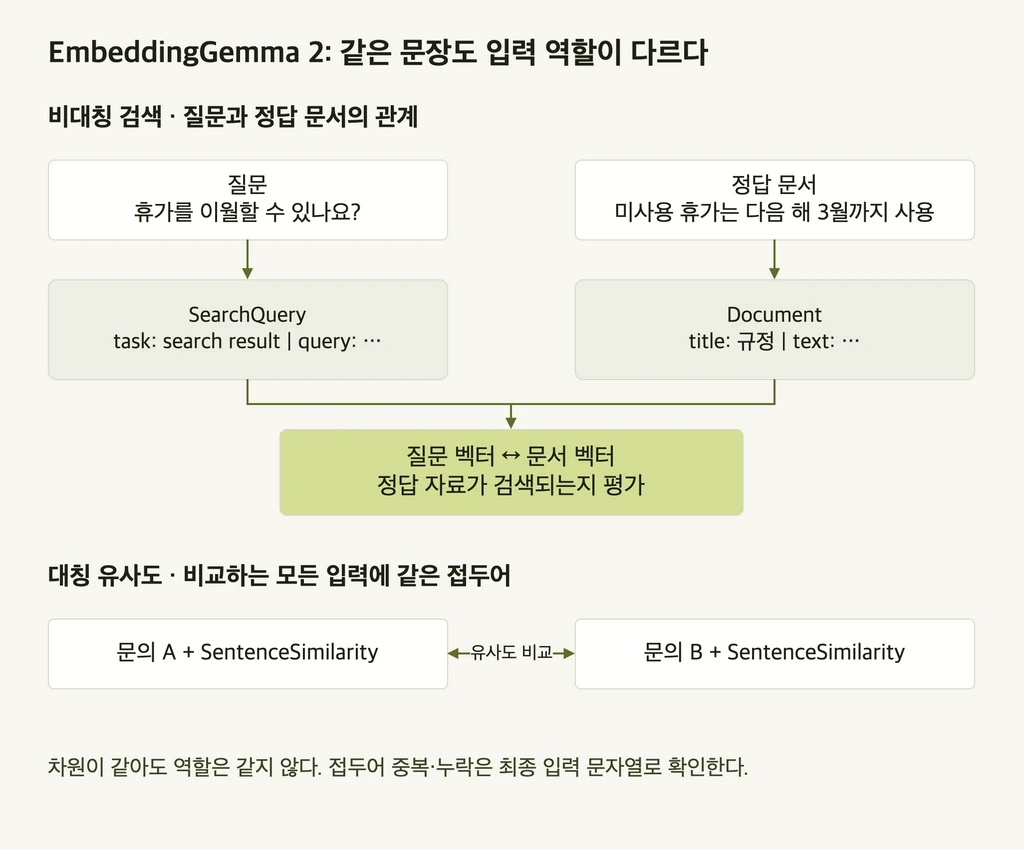
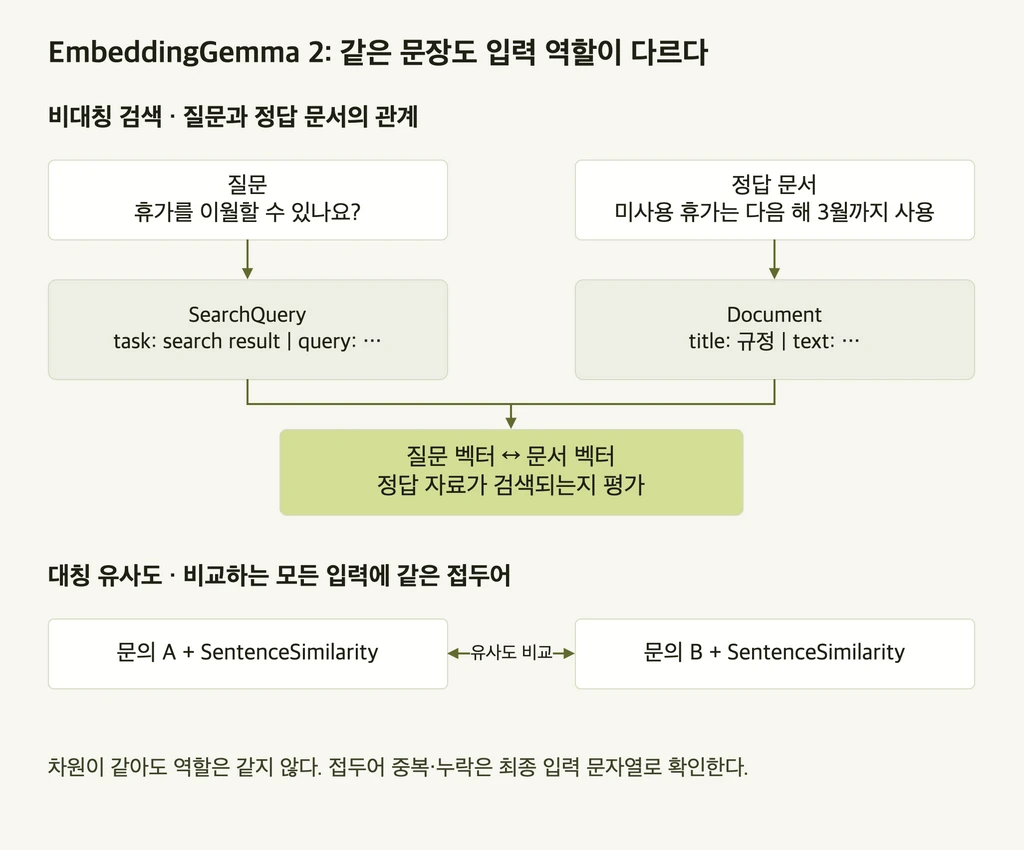
‘휴가를 이월할 수 있나요’라는 똑같은 문장이라도 관련 규정을 찾을 때와 비슷한 문의를 묶을 때는 목적이 다르다. 어떤 관계를 가깝다고 볼지 먼저 정해야 임베딩 벡터를 목적에 맞게 쓸 수 있다.
Google DeepMind가 2026년 10월 6일 공개한 EmbeddingGemma 2 모델 카드 (https://huggingface.co/google/embeddinggemma-2 (새 창))의 Prefix Notation & Usage와 공식 프롬프트 설정은 작업별 입력 규칙을 정의한다(인코더·벡터 차원 선택 참고).
질문과 정답 문서는 서로 닮을 필요가 없다
검색은 질문을 그대로 바꿔 쓴 문장이 아니라 질문에 필요한 정보를 담은 자료를 찾는 작업이다. 사내 규정 검색에서 ‘휴가를 이월할 수 있나요’의 정답이 ‘미사용 휴가는 다음 해 3월까지 사용할 수 있다’인 것처럼, 문장 형태가 달라도 질문과 답의 관계로 연결된다.
모델 카드는 검색을 비대칭 작업으로 분류하고, 질문에는 작업용 접두어를, 검색 대상 문서에는 제목·본문 형식을 적용한다. 반대로 문장 유사도나 군집화처럼 입력끼리 비교하는 대칭 작업에는 모든 입력에 같은 작업 접두어를 붙인다. 여기서 대칭과 비대칭은 코사인 유사도 계산식이 아니라 입력의 역할을 뜻한다.
모든 텍스트를 단일 임베딩 함수에 그대로 넘기면, 규정 검색에서 정답 문서를 찾는 일과 문의 분류에서 유사 문장을 묶는 일처럼 서로 다른 역할의 차이를 입력에 반영하지 못한다.
검색·질의응답·사실 확인은 찾을 자료가 다르다
공식 개발자 가이드 (https://developers.googleblog.com/en/embeddinggemma-2-the-developer-guide/ (새 창))에 따르면 모델은 짧은 작업 지시를 포함한 입력으로 학습됐으며, `prompt_name`으로 이를 지정한다. 이 접두어는 답변 말투를 정하는 프롬프트가 아니라 임베딩을 어떤 관계 비교에 쓸지 입력 단계에서 정의하는 장치다.
자연어 질문이라고 해서 항상 QuestionAnswering이 유리한 것은 아니다. 관련 자료를 넓게 찾을지(SearchQuery), 직접 답이 담긴 구절을 찾을지(QuestionAnswering)에 맞춰 정답 자료를 정하고 두 설정을 비교한다.
FactChecking으로 만든 벡터는 참·거짓 판정 결과가 아니며, 반박 자료도 중요한 검색 결과다. 비슷한 주장이 반복된다고 해서 사실로 단정하지 말고 출처와 내용을 검토해야 한다.
문의 간 유사도 비교에는 SentenceSimilarity, 주제별 묶기에는 Clustering, 분류용 표현 생성에는 Classification을 모든 입력에 똑같이 적용한다. 분류 접두어를 붙여도 라벨이 자동으로 결정되지는 않으므로 분류기나 비교 규칙을 별도로 설계해야 한다.
| 목적 | 프롬프트 이름과 정답 자료 |
|---|---|
| 문서 검색 | SearchQuery 요청 주제에 맞는 문서 |
| 질의응답 | QuestionAnswering 질문에 답할 내용을 담은 구절 |
| 사실 확인 | FactChecking 주장을 검토할 근거 |
| 코드 검색 | CodeRetrieval 요청한 동작을 구현한 코드 |
문서 제목과 자동 접두어를 두 번 붙이지 않는다
검색 계열의 네 작업은 문서 형식을 공유한다. 제목이 없는 본문에는 배포 설정 파일 (https://huggingface.co/google/embeddinggemma-2/blob/main/config_sentence_transformers.json (새 창))에서 `title: none | text: `에 대응하는 `prompt_name="Document"`를 쓰고, 제목이 있는 문서는 제목과 본문을 직접 조합한다.
배포 설정의 기본 프롬프트 이름은 null이므로 이름 없이 `encode()`를 호출하면 작업 접두어가 자동으로 선택되지 않는다. 또한 직접 구성한 제목 형식이나 질문 접두어에 `prompt_name`을 중복으로 지정하지 않도록 모델에 전달되는 최종 문자열을 확인해야 한다. 접두어가 누락되거나 중복돼도 벡터는 정상적으로 반환되므로 입력 의도와 일치하는지 직접 점검한다.
한국어 질문을 입력할 때도 공식 작업 문자열과 프롬프트 이름은 영문 그대로 유지하며, 이미지·오디오·영상 입력에는 텍스트용 접두어를 붙이지 않는다.
휴가 질문이 실제 모델 입력으로 바뀌는 과정을 따라가 보면 중복을 쉽게 찾을 수 있다. SearchQuery는 “task: search result | query: ” 뒤에 질문을 붙이고, 제목 없는 문서는 “title: none | text: ” 뒤에 규정 본문을 붙인다. 그다음 두 문자열을 각각 인코딩해 정규화한 벡터끼리 비교한다. 이미 완성한 질문 문자열에 SearchQuery를 다시 적용하면 작업 지시가 두 번 들어간다. 오류 없이 벡터가 나오더라도 학습할 때 기대한 입력 형식과는 달라진 셈이다.
코사인 식의 대칭성도 이 역할 차이를 없애지 못한다. 질문 벡터 q와 문서 벡터 d에 대해 q·d는 d·q와 같지만, 원문 문자열을 질문 역할로 인코딩한 값과 문서 역할로 인코딩한 값은 같다고 보장할 수 없다. 비교 순서를 바꾸는 것과 인코딩 전에 역할을 바꾸는 것은 서로 다른 연산이다.
import sentence_transformers as st

model = st.SentenceTransformer(
    "google/embeddinggemma-2"
)
question = "휴가를 이월할 수 있나요?"
passage = (
    "미사용 휴가는 다음 해 3월까지 "
    "사용할 수 있다."
)

task = "QuestionAnswering"
query_vec = model.encode(
    question, prompt_name=task
)

# 제목 없음: 자동 접두어
untitled_vec = model.encode(
    passage, prompt_name="Document"
)

# 제목 있음: 수동 포맷
# Document를 덧붙이지 않는다.
titled = (
    "title: 연차휴가 규정 | "
    f"text: {passage}"
)
titled_vec = model.encode(titled)
질문 설정을 바꾸는 일과 색인을 다시 만드는 일을 구분한다
규정 검색을 문서 탐색과 질의응답으로 나눌 때, 문서를 동일한 Document 형식으로 유지하면 모델과 문서 입력이 같다는 조건 아래 기존 문서 벡터를 그대로 두고 질문의 SearchQuery와 QuestionAnswering만 비교할 수 있다.
반면 문서 제목을 새로 붙이거나 본문에 다른 작업 접두어를 넣거나 분할 규칙을 바꾸면 모델 입력이 달라지므로, 문서 벡터를 다시 계산해 이전 색인과 분리하여 평가해야 한다. 벡터 차원이 같더라도 역할이 다른 클러스터링용 벡터와 검색용 문서 벡터는 섞어 쓰지 않는다.
문서 입력 규칙과 질문 서비스 설정의 호환성을 관리하려면 색인 메타데이터에 모델 리비전, 문서 입력 형식, 접두어 적용 위치, 분할 규칙, 벡터 차원, 정규화 여부를 남기고 질문 서비스에는 작업 이름을 기록한다. 질문 접두어만 바꾸면 문서 재계산 비용을 아낄 수 있지만, 문서 입력을 바꾸면 전체 임베딩을 다시 생성하고 저장·검증하는 비용이 추가된다.
문서가 100만 개이고 하루 질문이 1만 개라는 가상 규모를 생각해 보자. SearchQuery와 QuestionAnswering을 비교할 때는 같은 Document 벡터를 유지한 채 질문을 두 형식으로만 인코딩하면 된다. 반면 문서 제목 형식을 바꾸는 실험은 100만 개의 문서 입력을 다시 처리해야 한다. 차원을 바꾸지 않았더라도 입력 문자열이 달라졌기 때문이다. 따라서 실험 기록에는 “모델은 같음”만 적기보다 어느 쪽 입력을 바꿨는지 남겨야 재색인 비용과 검색 품질 변화를 연결해 파악할 수 있다.
접두어의 이름보다 정답 자료로 선택한다
도입 시험에서는 모델 리비전·문서 입력·분할·차원·정규화를 고정하고 질문 접두어만 바꿔 가며 비교한다. 무접두어는 기준선으로만 두고 권장 설정과 혼용하지 않는다. 같은 질문 묶음에서 정답 자료가 상위에 오르는지, 단어만 비슷하고 답이 없는 문서가 앞서는지 기록하면 원인을 좁힐 수 있다.
검색과 질의응답은 정답 문서나 구절로 평가하고, 사실 확인은 뒷받침 자료와 반박 자료를 모두 포함하며, 유사도 작업에는 의미가 같은 쌍과 단어만 겹치는 쌍을 함께 넣는다. 문서 검색 점수가 높은 설정을 문의 군집화에 그대로 쓰지 않으며, 검색 품질이 낮을 때는 모델을 교체하기 전에 질문 작업 이름과 문서 형식이 의도대로 입력됐는지 먼저 확인한다.
참고 자료
EmbeddingGemma 2 Model Card (새 창) — Google DeepMind, Prefix Notation & Usage
EmbeddingGemma 2 배포 프롬프트 설정 (새 창) — config_sentence_transformers.json
EmbeddingGemma 2: The Developer Guide (새 창) — Maarten Grootendorst · Ian Ballantyne, 2026년 10월 6일