vLLM prefix caching은 무엇을 재사용하나: 블록 해시에서 퇴출까지
vLLM이 같은 접두어의 KV를 찾는 과정을 해시 연결과 블록 예제로 설명한다. 참조 해제와 퇴출의 차이, prefill을 줄여도 전체 응답이 같은 비율로 빨라지지 않는 이유까지 따라간다.
vLLM의 prefix caching은 문서나 답변을 통째로 저장하는 검색 기능이 아니다. 앞에서부터 같은 토큰을 읽었을 때 계산해 둔 KV를 재사용하는 기능이다. 그래서 긴 문서를 그대로 다시 보내더라도 그 앞에 요청 시각을 끼워 넣으면 재사용 범위가 달라진다. 왜 앞부분의 작은 변경이 뒤에 이어지는 긴 문서에까지 영향을 줄까?
답은 캐시 키가 ‘현재 블록의 내용’만 가리키지 않는다는 데 있다. 이 글은 일반적인 자기회귀 Transformer의 접두어 재사용 방식을 다룬다. 블록 크기가 4인 공식 예시와 고정된 버전의 vLLM 코드를 따라가며 설명하고, 해시와 시간 계산은 별도의 작은 예제로 검증한다. GPU 서버의 성능을 측정한 글은 아니다.
같은 토큰에도 앞 문맥이 따라붙는다
자기회귀 Transformer에서 뒤 토큰의 표현은 앞 토큰을 참고한다. 여러 층을 거친 KV를 단어별 사전처럼 단순히 떼어내 재사용하면 앞 문맥의 차이를 놓치게 된다. ‘은행’이라는 같은 토큰이라도 앞 문맥이 달라졌다면 중간 계산 결과가 같다고 가정할 수 없다. 따라서 이 의존성을 캐시 키에 반영해야 한다.
vLLM 설계 문서 (새 창)를 보면 부모 블록의 해시, 현재 토큰, 추가 키를 묶어 해시를 만든다. 추가 키에는 LoRA나 멀티모달 입력을 구별하는 정보 등이 들어간다. hash_block_tokens 구현 (새 창)에서도 부모 해시, 토큰 튜플, extra_keys라는 세 요소를 해시 함수에 전달하는 것을 확인할 수 있다.
설명을 위해 입력을 [ABCD], [EFGH], [IJKL] 블록으로 나누어 생각해 보자. 첫 번째 키 h1은 시작값과 ABCD로 만들고, h2는 h1과 EFGH로, h3는 h2와 IJKL로 만든다. 만약 첫 토큰 A만 Z로 바꾸면 h1이 달라지고, 두 번째 블록이 똑같이 EFGH라도 부모 해시가 달라졌기 때문에 h2까지 바뀐다. 이어서 IJKL의 해시도 영향을 받는다. 해시 충돌을 배제한 이 예시에서, 뒤쪽 두 블록의 문자열이 같더라도 캐시는 일치하지 않는다.
반대로 마지막 블록만 IJkl로 바꾸면 앞선 h1과 h2는 그대로 유지된다. 즉, 캐시는 ‘문서가 같은가’가 아니라 ‘앞에서부터 어디까지 같은 조건으로 계산했는가’를 따진다. 실제 요청에서는 문자 대신 토큰 ID를 비교하며, 채팅 템플릿과 역할 표시도 입력에 포함된다. 문장 위치를 옮겨 캐시 적중률을 높이려 한다면 지시 우선순위와 답변의 의미가 그대로 유지되는지도 함께 확인한다.
| 입력변경 | h1 | h2 | h3 |
|---|---|---|---|
| ABCD / EFGH / IJKL | 기준 | 기준 | 기준 |
| ZBCD / EFGH / IJKL | 변경 | 부모변경으로 변경 | 부모변경으로 변경 |
| ABCD / EFGH / IJkl | 유지 | 유지 | 변경 |
공통 토큰 10개가 블록 두 개가 되는 과정
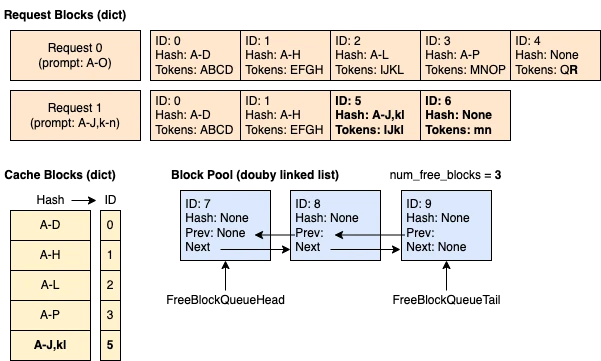
아래 공식 그림 (새 창)에서 Request 1은 A부터 J까지 Request 0과 같고, 뒤이어 오는 k부터 n까지가 다르다. 설명을 위해 블록 크기는 4로 두었다. 첫 두 블록인 ABCD와 EFGH는 완전히 같지만, 세 번째 블록은 IJKL과 IJkl로 갈라진다. 앞선 10개 토큰이 같더라도 실제로 재사용할 수 있는 완성 블록은 두 개, 즉 8개 토큰뿐이다. 그림에서 블록 ID 0과 1은 공유하고, ID 5와 6은 새로 배정한다.
단일 종류의 블록만 쓰는 단순한 조건에서 공통 접두어 길이를 L, 블록 크기를 B라고 하면, 완성된 공통 블록의 토큰 수는 B×floor(L/B)로 구할 수 있다. L=10, B=4라면 결과는 8이다. L=11이어도 여전히 8이고, L=12가 되어야 12로 늘어난다. 이처럼 계단식으로 변하기 때문에 공통 토큰이 하나 늘어난다고 해서 매번 재사용량이 늘어나지는 않는다. 물론 이는 완성 블록의 경계를 설명하기 위한 계산이며, 실제로는 해당 블록이 캐시에 남아 있어야 한다는 조건도 충족해야 한다.
현재 기능 문서 (새 창)는 하이브리드 Mamba 모델의 별도 접두어 체크포인트와 매칭 단위를 설명한다. 앞서 본 단순 수식을 모든 모델의 적중 토큰 계산에 그대로 적용할 수는 없다. 모델의 캐시 그룹과 현재 사용 중인 설정을 먼저 구분한다.
참조가 끝난 블록은 언제 사라지는가
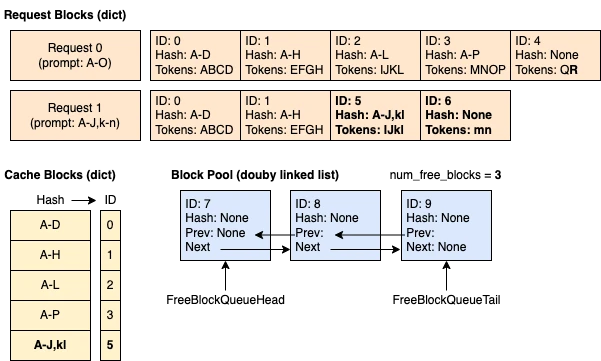
해시 키가 같더라도 KV가 메모리에 남아 있지 않으면 다시 계산해야 한다. 블록 풀 코드 (새 창)의 touch는 블록의 참조 수를 늘리고, 참조 수가 0이던 블록을 다시 쓸 때는 빈 블록 큐에서 꺼낸다. 반대로 free_blocks는 참조 수를 줄이고, 참조 수가 0이 된 블록을 다시 큐로 돌려보낸다. 여기서 요청이 블록 참조를 놓는 것과 캐시 매핑이 실제로 퇴출되는 것은 별개의 사건이다.
예를 들어 요청 R0가 ID 0인 ABCD 블록을 쓰는 중에 R1도 같은 블록에 적중하면 참조 수는 1에서 2로 늘어난다. R0가 끝나더라도 참조 수가 1로 남아 있으므로, R1이 사용 중인 이 블록을 다른 내용으로 덮어쓸 수 없다. 이후 R1까지 끝나 참조 수가 0이 되면 이 블록은 재사용 및 퇴출 후보가 된다. 다른 요청이 이 공간을 덮어쓰기 전에 ABCD가 다시 들어오면 기존 계산을 살려 쓸 수 있지만, 새 요청의 공간을 확보하는 데 쓰이고 나면 같은 키로 조회해도 이전 계산 결과는 남아 있지 않다.
이 수명 예시는 코드에서 참조 수가 변하는 흐름만 단순화해 나타낸 것이다. 특정 요청의 정확한 퇴출 순서나 실제 메모리 주소까지 예측하지는 않는다. 여기서 중요한 것은 ‘입력이 같아 재사용할 자격이 있는 상태’와 ‘그 계산 결과가 지금도 메모리에 남아 있는 상태’를 구분하는 일이다. 전자는 해시와 모델 조건에, 후자는 블록의 수명과 메모리 압력에 달려 있다.
prefill을 없애도 decode는 남는다
기능 문서 (새 창)에서 설명하듯 APC의 핵심 이득은 공통 접두어의 prefill 계산을 생략하는 데 있다. 새로운 답변 토큰을 하나씩 생성하는 decode 과정 자체를 없애지는 않는다. KV 캐시는 완성된 답변 문장을 저장하는 캐시가 아니므로, 질문이 바뀌면 해당 문맥을 바탕으로 새로운 출력을 생성해야 한다.
계산을 단순화해 대기 시간이 100ms, prefill이 900ms, decode가 1,000ms인 가상의 요청을 가정해 보자. 전체 소요 시간은 2,000ms다. 캐시를 적용해 prefill이 100ms로 줄어든다면 전체 시간은 1,200ms가 된다. prefill 구간만 보면 9배 빨라졌지만, 전체 시간 기준으로는 약 1.67배 빨라진 셈이다. 만약 나머지 조건이 같고 decode만 9,000ms 걸리는 요청이라면, 전체 시간은 10,000ms에서 9,200ms로 줄어 약 1.09배 개선되는 데 그친다. 이 단순 산술은 실제 vLLM 벤치마크 결과가 아니라, 캐시 이후에도 남는 비용이 전체 시간에 미치는 영향을 보여준다.
공통 입력이 길고 출력이 짧은 요청일수록 효과를 보기 쉽지만, 실제 서버의 혼잡도와 블록 확보 대기 시간은 별도로 측정해야 한다. 또한 cache_salt는 캐시 공유 범위를 구분하는 입력값이다. 적중률을 높이겠다며 서로 다른 신뢰 그룹의 salt를 합치는 것은 단순한 캐시 튜닝으로 볼 일이 아니다.
실패 지점을 네 가지로 나눈다
문서가 같은데도 캐시에 적중하지 않는다면 가장 먼저 최종 토큰 배열을 비교한다. 앞부분에 들어간 시각 정보나 역할 표시, 템플릿 차이 때문에 공통 접두어가 끊겼다면 프롬프트 배치 문제다. 토큰 배열이 같더라도 LoRA, 이미지, salt 값이 다르다면 계산 조건이 달라진 것이다. 계산 조건까지 모두 같은데 블록이 사라졌다면 수명 문제다. 만약 캐시에 적중했는데도 답변 완료 시간이 비슷하다면 대기 시간과 decode 구간이 전체 시간을 좌우하고 있는지 확인한다.
검증할 때는 동일한 모델, 설정, 질문을 기준으로 캐시가 없는 요청과 캐시가 준비된 요청을 비교하며 TTFT, 적중 토큰, 전체 시간을 나누어 기록한다. 그다음에는 첫 블록만 바꾼 요청과 마지막 블록만 바꾼 요청을 대조해 본다. 이는 앞서 살펴본 해시 예제를 실제 입력으로 재현해 보는 과정이며, 측정 결과를 미리 단정하지는 않는다. 캐시 동작을 설명할 때 필요한 것은 캐시를 ‘켰다’는 설정값 하나가 아니라, 어떤 계산을 왜 재사용했고 언제 잃었는지를 남긴 기록이다.