Continuous batching은 빈자리를 어떻게 채울까: 토큰 예산과 KV 캐시
짧은 답변과 긴 입력을 함께 처리하는 단계별 예제로 continuous batching을 설명한다. query 토큰 예산과 KV 메모리를 구분하고, 청크 크기가 첫 응답과 토큰 간격에 미치는 영향을 따라간다.
LLM 서버에서 짧은 답변 하나가 끝났는데도 다음 요청을 넣지 못하면 GPU 자리를 낭비할 수 있다. Continuous batching은 묶음 전체가 끝날 때까지 기다리는 대신, 모델 실행 단계마다 완료된 요청을 빼고 새 요청을 넣는다. 이때 달라지는 것은 모델 크기가 아니라 해당 단계에서 계산할 요청과 토큰 구성이다.
하지만 자리가 났다고 해서 바로 새 요청을 처리할 수 있는 것은 아니다. 긴 입력을 읽을 토큰 예산과 이전 계산 결과를 보관할 KV 캐시 공간도 필요하다. 짧은 답변과 긴 문서 요청을 함께 처리하는 간단한 예시로 이 세 가지 조건을 분리해 보자. 아래 표와 시간은 설명을 위한 가정일 뿐, 실제 서버 벤치마크가 아니다.
완료된 요청을 뺀 다음 단계에는 누가 들어오는가
이미 입력 처리가 끝난 요청 A와 B가 있고, 생성할 출력이 각각 2개와 4개 토큰 남았다고 가정하자. 각 요청은 한 단계마다 출력 토큰을 하나씩 생성한다. 처음 두 단계에서는 A와 B가 함께 실행된다. 두 번째 단계가 끝나고 A가 완료되더라도, 고정 배치 방식에서는 B가 끝날 때까지 기다려야 하므로 세 번째와 네 번째 단계 동안 A의 자리가 비어 있게 된다. 반면 Continuous batching은 세 번째 단계부터 그 빈자리에 대기 중인 요청 C의 입력 처리를 넣을 수 있다.
이 예시는 단계마다 빈자리를 채우는 방식의 차이를 보여줄 뿐, 세 번째 단계가 이전 단계와 똑같은 시간에 끝난다고 가정하지 않는다. 여러 입력 토큰을 읽는 prefill과 다음 토큰 하나만 만드는 decode는 작업량이 다르기 때문이다. “빈자리 하나”를 “어떤 요청이든 같은 비용으로 들어갈 수 있는 자리”로 해석하면 지연을 설명하기 어렵다.
Transformers 사용 문서 (새 창)는 generate_batch와 ContinuousBatchingManager를 구분한다. 전자는 전체 요청이 모두 완료됐을 때 호출 결과를 반환하고, 후자는 요청을 계속 추가하면서 개별 결과를 받아볼 수 있는 관리 인터페이스를 제공한다. 내부 배치가 계속 바뀐다는 점과 사용자에게 결과를 언제 전달할지는 별개의 선택이다.
prefill 네 토큰과 decode 한 토큰을 함께 넣는다
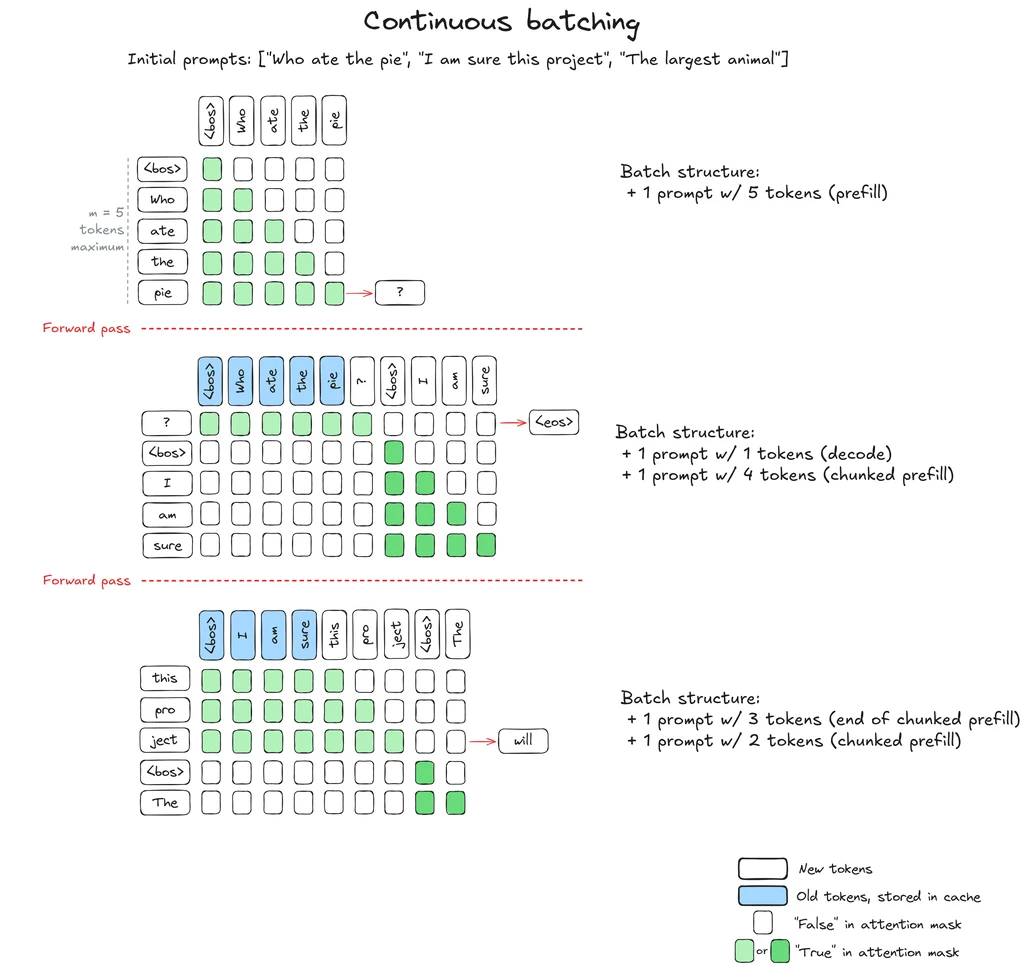
Hugging Face의 원리 설명 (새 창)은 긴 prefill을 쪼개 기존 decode와 함께 배치하는 과정을 보여준다. 아래 그림의 가운데 단계에는 decode 토큰 하나와 prefill 토큰 네 개가 함께 들어간다. 빨간 점선은 실행 단계, 파란색은 이미 계산된 캐시, 초록색은 허용된 어텐션 연결을 뜻한다. 토큰 예산 5는 원리를 보여 주기 위한 예시값이다.
앞서 A가 완료된 뒤 B의 decode가 이어지고, C는 입력 토큰 7개를 처리하기 위해 대기 중이라고 하자. 한 단계에 처리할 새 query 토큰 예산을 5로 정하고 decode에 먼저 배정한다. 세 번째 단계에서는 B에 1개, C에 4개를 할당한다. 이제 C의 입력은 3개 남는다. 네 번째 단계에서도 B에 1개를 먼저 배정한 뒤, C의 남은 입력 3개를 마저 처리한다. 마지막 입력 조각까지 처리하고 나면 C의 첫 출력 토큰을 예측할 수 있다. 그다음부터 C도 decode 단계로 넘어간다.
C는 앞 단계에서 계산한 KV를 저장해 두므로 네 번째 단계에서 입력 토큰 7개를 처음부터 다시 처리하지 않는다. 그렇다고 앞서 처리한 4개 토큰을 무시하는 것도 아니다. 새 토큰은 이전 문맥에 주의를 기울이고, 캐시는 그 문맥을 다시 계산하는 비용을 줄여 준다. 이때 B와 C의 문맥이 서로 섞이지 않도록 구분한다. 이러한 구조 덕분에 긴 입력을 잘라 넣으면서도 각 요청의 인과적 문맥을 온전히 유지할 수 있다.
| 단계 | 이번에 처리할 query | 단계 뒤 상태 |
|---|---|---|
| 1 | A decode 1 + B decode 1 | A 출력1·B 출력3 남음 |
| 2 | A decode 1 + B decode 1 | A 완료·B 출력2 남음 |
| 3 | B decode 1 + C prefill 4 | B 출력1·C 입력3 남음 |
| 4 | B decode 1 + C prefill 3 | B 완료·C 첫 출력 예측 가능 |
요청 수, query 토큰 수, KV 공간은 서로 다르다
Transformers 구조 문서 (새 창)는 한 실행 단계의 query 토큰 예산, KV 캐시 예산, 요청 수 상한을 구분한다. 기본 FIFOScheduler는 진행 중인 decode, 진행 중인 prefill, 새 대기 요청 순으로 배치를 채운다. 위의 B·C 예시는 이 우선순위를 단순화한 것이며, 모든 추론 엔진에 공통으로 적용되는 규칙은 아니다.
세 번째 단계에서 처리하는 요청 수는 B와 C, 두 개다. 새로 계산하는 query 토큰은 1+4=5개다. 그런데 B가 긴 대화를 이어 왔다면 이미 저장된 과거 KV는 훨씬 많을 수 있다. “이번 단계에서 5개만 계산한다”는 말이 “캐시에도 5개만 저장한다”는 뜻은 아니다. 현재 단계에서 처리할 입력량과 각 요청이 유지하는 상태량은 서로 다른 예산을 사용한다.
한 종류의 KV가 토큰당 차지하는 크기는 단순화하면 2×층 수×KV 헤드 수×헤드 차원×원소 바이트 수로 계산할 수 있다. 여기서 2는 key와 value를 뜻한다. 가상 모델의 층 수가 32, KV 헤드 수가 8, 헤드 차원이 128, 원소 크기가 2바이트라면 토큰당 131,072바이트, 즉 128KiB를 차지한다. 길이가 8,192인 상태라면 요청 하나당 1GiB가 필요하다. 이는 모델 가중치·활성값·페이지 낭비를 제외하고, 모든 층이 동일한 full attention을 사용한다고 가정한 계산이다.
따라서 query 예산이 남아 있더라도 KV 공간이 부족하면 새 요청 C를 받아들이기 어렵다. 반대로 캐시 공간이 넉넉해도 query 예산이나 요청 수 상한을 넘기면 같은 단계에 모두 넣을 수 없다. 이 중 어떤 제약에 먼저 걸리는지 구분해야 설정 변경의 효과를 제대로 설명할 수 있다.
청크 크기를 줄이면 누구의 대기 시간이 늘어나는가
C의 prefill을 더 작게 쪼개면 B가 다음 토큰을 기다리며 겪는 한 번의 긴 멈춤을 줄일 수 있다. 대신 C는 입력 처리를 마칠 때까지 더 많은 실행 단계를 거쳐야 한다. 각 단계마다 드는 준비 비용과 뒤따르는 요청들과의 경쟁도 남는다. 따라서 청크를 작게 나눈다고 해서 모든 요청의 첫 토큰 생성 시간이 동시에 줄어드는 것은 아니다.
가상 시간표에서 B의 마지막 출력이 t=0ms에 나왔다고 하자. C의 긴 prefill을 한 번에 처리하느라 다음 B 토큰이 t=120ms에 나온다면 B의 토큰 간격은 120ms가 된다. 같은 작업을 나누어 처리해 B 토큰을 t=40ms와 t=80ms에 내보내면 토큰 간격은 각각 40ms로 줄어든다. 하지만 이 정보만으로는 C의 첫 토큰이 언제 나왔는지 알 수 없다. C의 마지막 입력 조각이 언제 처리됐는지도 함께 기록해야 한다. 이 숫자는 스케줄링 선택에 따른 차이를 설명하기 위한 가정이다.
처리량 역시 별개의 문제다. 여러 요청을 함께 실행하면 계산 자원을 더 알차게 채울 수 있지만, 요청별 지연과 전체 완료 시간은 작업 구성과 부하에 따라 달라진다. 초당 생성 토큰 수가 늘었다는 지표만으로 B의 대화가 매끄러워졌다거나 C의 응답이 빨리 시작됐다고 결론 내릴 수는 없다.
같은 도착 기록으로 대기 시간을 분해한다
짧은 질의응답과 긴 문서 요약을 함께 처리하는 서비스라면 모델·정밀도·하드웨어·길이 분포를 고정한 채 동일한 요청 도착 기록을 두 설정에 재생해 볼 수 있다. 첫 토큰 시간은 큐에서 대기한 시간과 입력 처리 시간을 구분해 기록한다. 출력이 시작된 뒤에는 토큰 간 간격과 전체 완료 시간을 살핀다. 이는 검증 방법을 제안하는 것일 뿐, 이 글에서 실제로 수행한 서버 실험은 아니다.
각 지표의 p95는 관측값의 95%가 그 이하에 속하는 지점을 뜻하며, 최악의 지연 시간과는 다르다. 오류율과 처리량을 함께 살피되, 먼저 허용 가능한 첫 응답 시간과 답변 중간 지연 기준을 정한다. 그 조건을 만족하는 설정끼리 처리량을 비교하면 느린 요청을 희생시켜 얻은 개선을 가려내기 쉽다.
대기열이 길어진다면 요청이 들어오는 속도와 처리 속도의 차이부터 확인한다. 입력 처리 시간만 길다면 prefill 분할 설정을, 출력 도중 멈춤이 길다면 decode가 어떤 작업과 함께 배치됐는지를 살펴본다. KV 공간이 먼저 차는 상황에서는 query 토큰 예산만 늘려도 문제가 해결되지 않는다. Continuous batching의 핵심은 빈자리를 채우는 데서 출발하지만, 실제 운영 판단은 어떤 예산을 써서 누구의 기다림을 줄였는가에서 갈린다.