UltraBERT는 왜 예측층을 나눌까: 마스킹 비율과 기울기가 만나는 지점
UltraBERT의 공유 인코더와 분리된 LM 헤드를 따라가며 마스킹 비율, 토큰별 손실 집계, 기울기 상쇄를 계산한다. 분류·검색 평가를 따로 읽어야 하는 이유도 짚는다.
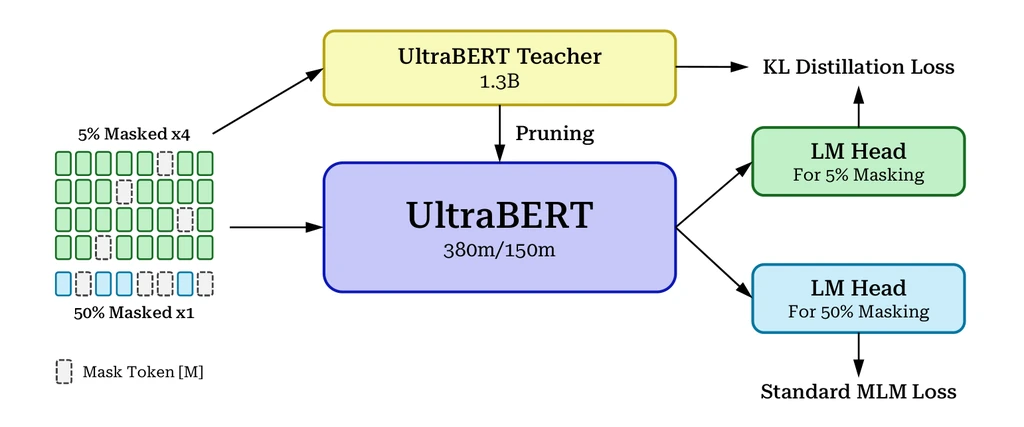
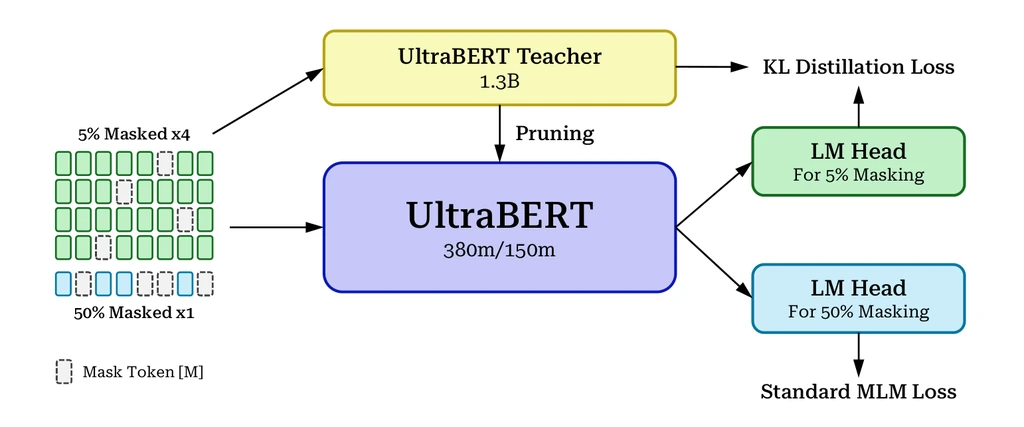
인코더 하나로 분류와 검색을 모두 잘하게 만들려면 두 작업의 데이터를 섞기만 하면 될까. UltraBERT는 입력을 가리는 비율뿐 아니라 가린 토큰을 예측하는 출력층의 공유 여부까지 달리했다. 같은 본체를 학습시키면서 서로 다른 목표가 만나는 위치를 조절한 실험이다.
공유 본체와 두 예측층의 계산을 따라가며 입력 개수, 예측 토큰 수, 기울기의 차이를 나눠 보자. 아래 벡터와 손실 계산은 설명을 위한 가정이며, 사전학습이나 한국어 검색 실험을 실제로 실행한 결과는 아니다.
분류용 헤드 두 개를 붙였다는 뜻은 아니다
10월 14일 공개된 연구진의 UltraBERT 해설 (새 창)은 10월 10일 제출된 논문의 학습법을 설명한다. 마스킹 언어 모델링(MLM)은 입력 토큰 일부를 가리고 원래 토큰을 맞히는 학습이고, LM 헤드는 인코더의 표현을 어휘별 예측 점수로 바꾸는 출력층이다. 여기서 분리하는 대상은 분류·검색 서비스의 최종 출력층이 아니라 사전학습 단계의 LM 헤드다.
연구진은 한 배치 안에 5%와 50%를 가린 입력을 섞고 각 비율에 별도 LM 헤드를 두되, 인코더 본체는 공유한다. 논문 3.4절 (새 창)은 두 비율에서 학습한 헤드의 기하 구조 차이를 분석하고, 헤드를 공유하면 학습 신호가 서로 간섭할 수 있다는 가설을 검토한다. 헤드를 나눈다고 해서 본체까지 서로 독립된 모델이 되는 것은 아니다.
인코더가 한 위치의 표현 h를 만들면 LM 헤드는 W×h+b로 어휘별 점수를 계산하고 softmax로 확률을 구한다. 같은 h라도 W가 다르면 토큰 순위가 달라진다. 마스킹이 적을 때 주변 단서로 맞히는 문제와 절반을 가렸을 때 넓은 문맥을 추론하는 문제를 서로 다른 출력 변환으로 학습하는 셈이다. 이 구조는 본체를 두 번 복제하는 것과는 다르다.
같은 혼합 입력에서 헤드만 나눈 비교
아래는 논문 표 1의 150M 인코더 비교에서 네 가지 설정을 추린 결과다. GLUE는 분류 평가 묶음의 점수이고, BEIR는 MS MARCO로 검색 미세조정한 뒤 얻은 평균 nDCG@10으로 검색 순위 품질을 측정한다. 서로 다른 두 열의 점수를 더해 하나의 정확도로 읽어서는 안 된다.
| 사전학습 설정 | GLUE | BEIR |
|---|---|---|
| 6% 단일 비율 | 89.5 | 43.5 |
| 50% 단일 비율 | 87.5 | 45.0 |
| 5%·50% 혼합, 헤드 공유 | 88.9 | 44.7 |
| 5%·50% 혼합, 헤드 분리 | 89.4 | 45.1 |
두 지표가 함께 올라도 확인할 것은 남는다
혼합 입력에서 헤드를 나눴을 때 두 지표가 함께 오른 결과는 단순 데이터 혼합과 출력층 분리의 차이를 보여준다. 다만 GLUE 89.4를 단일 비율의 89.5보다 높다고 해석하면 틀린다. 이 표만으로는 작은 점수 차이가 여러 시드에서 안정적으로 반복되는지도 확정할 수 없다.
본체를 통째로 분리하기 전에 학습 목표가 어휘 예측 점수로 바뀌는 지점만 따로 둘 수 있다. 다만 모든 다중 작업 학습에서 헤드 분리가 최선이라고 일반화하거나, 공유 본체로 들어오는 신호의 충돌까지 완전히 사라졌다고 가정해서는 안 된다.
공유 인코더 파라미터를 θ, 두 헤드의 손실을 L낮음과 L높음이라고 하면 본체 갱신에는 α∇θL낮음+β∇θL높음이 함께 반영된다. 가상으로 두 기울기가 (1,0)과 (−1,1)이고 가중치가 같다면 합은 (0,1)이 되어 첫 좌표의 신호는 상쇄된다. 헤드를 분리해 각 손실의 경로를 바꿀 수는 있지만, 공유 본체에서 일어나는 상쇄가 자동으로 사라지는 것은 아니다.
입력 개수 4:1은 학습 신호 4:1과 다르다
최종 학습법은 5% 마스킹 입력을 50% 입력보다 네 배 많이 넣는다. 이때 낮은 비율에서는 예측할 토큰이 적다는 조건도 함께 봐야 한다. 저자 해설의 학습 구성 (새 창)에서는 낮은 비율에만 교사의 예측 분포를 배우는 증류를 적용하고, 높은 비율에는 일반 MLM 손실을 쓴다.
가령 길이 100토큰짜리 입력 다섯 개를 4:1로 섞으면, 5%를 가린 입력 네 개의 예측 대상은 총 20개이고 50%를 가린 입력 한 개의 예측 대상은 50개다. 입력 개수의 비율이 예측 대상 토큰 수의 비율로 그대로 이어지지는 않는다.
이 개수를 본체에 미치는 영향력으로 곧바로 환산할 수도 없다. 실제로는 손실을 토큰별로 평균 내는지, 비율별 손실을 어떻게 합치는지, 교사의 예측 분포가 어떤지에 따라 기울기가 달라진다. 재현 실험에서는 입력 수와 함께 비율별 예측 토큰 수, 손실 집계 방식, 기울기 크기를 기록해야 한다. 4:1 비율을 그대로 가져오는 것보다 무엇이 4:1인지 확인하는 편이 먼저다.
두 경로의 토큰당 평균 손실이 각각 2와 4라고 가정해 보자. 20개와 50개를 한꺼번에 평균 내면 (20×2+50×4)/70=약 3.43이다. 반면 경로별 평균을 같은 비중으로 합치면 (2+4)/2=3이다. 같은 입력과 예측을 써도 집계 규칙에 따라 최적화 목표가 달라진다. 이는 실제 UltraBERT의 손실 집계를 재현한 값이 아니라, 집계 규칙을 확인해야 하는 이유를 보여준다.
분류와 검색을 함께 운영한다면
기술 지원 서비스에서 같은 문서를 장애 유형별로 분류하고 유사 사례 검색에도 쓴다면 공통 인코더를 검토할 만하다. 분류는 틀리면 안 되는 유형을 나눠 평가하고, 검색은 실제 질문과 정답 문서로 순위 품질을 따로 본다. 한쪽 평균이 올라도 드문 장애 유형이나 정확한 오류 코드 검색이 나빠지면 채택을 보류해야 한다.
논문의 표는 작업별 미세조정을 거친 성능이다. 공개된 기본 체크포인트 하나를 그대로 불러와도 분류와 검색을 모두 같은 수준으로 해낸다는 뜻은 아니다. 바로 가져다 쓰는 UltraBERT-Embed와 기본 인코더의 평가도 구분해야 하며, 영어 중심 결과를 한국어 지원 문서의 효과로 일반화할 수는 없다.
직접 사전학습하지 않고 공개 모델을 고르는 단계라면 마스킹 비율을 서비스 입력에 적용할 필요는 없다. 실제 업무 평가와 미세조정 비용부터 비교하면 된다.
검색 순위 역시 평균에 가려지는 차이가 있다. 정답 문서가 하나인 가상 질문에서 정답이 1위이면 nDCG@10은 1이고, 2위이면 1/log₂(3)=약 0.631이다. 비슷한 점수 상승이라도 이미 잘 찾던 질문이 더 좋아진 것인지, 필요한 문서를 못 찾던 질문이 살아난 것인지는 다르다. 오류 코드와 자연어 증상을 나눠 보면 인코더 교체의 효과를 구체적으로 판단할 수 있다.
공유 본체보다 앞서 학습 경로를 점검하기
비슷한 두 작업을 한 모델에 합칠 때는 데이터의 혼합 비율과 손실이 본체에 도달하는 경로를 함께 비교해야 한다. 공유 헤드와 분리 헤드를 같은 예산으로 맞추고 작업별 회귀를 따로 확인한다. 한 모델로 합쳤다는 사실보다 어느 작업에서 무엇을 잃었는지 드러나는 비교가 도입 판단에 더 도움이 된다.