사용자 수정이 곧 정답은 아니다: 실패 로그를 회귀 평가로 바꾸는 법
사용자 교정과 실행 당시의 데이터 상태를 연결한다. 정책 변경 사례와 양방향 시험으로 잘못된 정답을 학습하는 개선 루프를 피한다.
프롬프트를 고친 뒤 같은 실패가 줄었더라도, 다른 작업에서 발생한 회귀나 트래픽 변화 때문일 수 있다. 수정 전의 실패를 같은 조건에서 재현할 수 있어야 변경 효과를 제대로 비교할 수 있다.
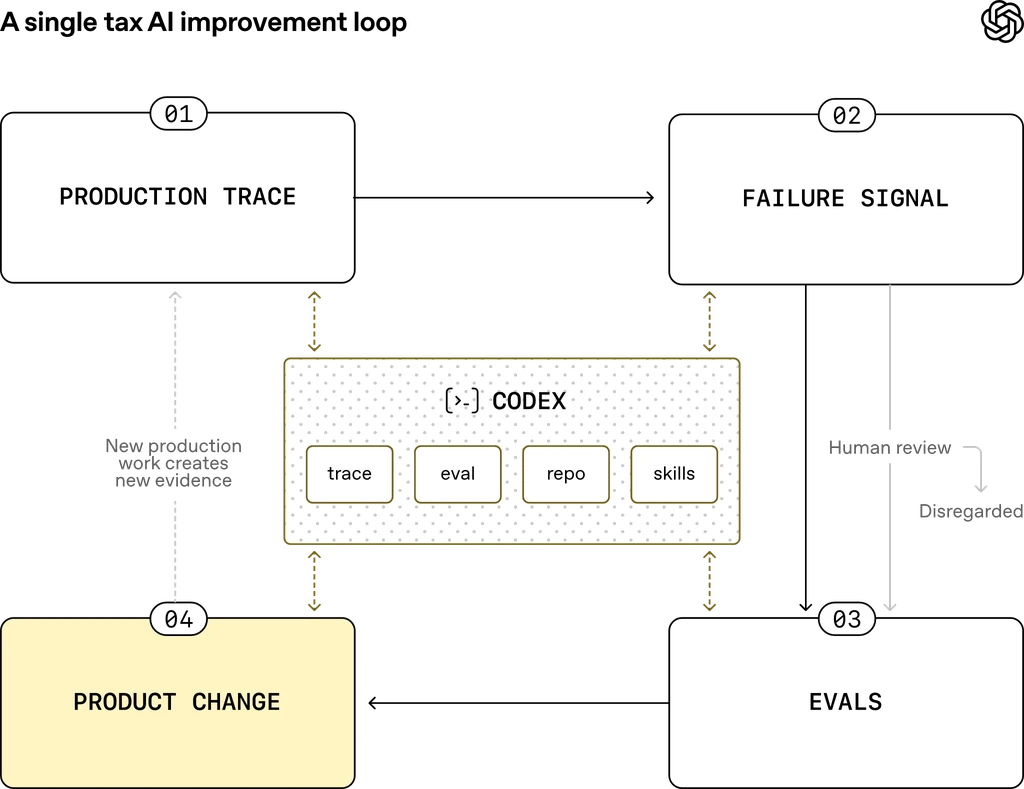
OpenAI의 세무 에이전트 사례에서는 실무자가 고친 필드와 제품의 실행 기록을 연결하고, 반복되는 실패를 평가 항목으로 만든다. 운영 중에 발생한 실패를 다음 배포의 테스트로 보존하는 방식이다.
자동 개선의 정의
여기서 말하는 자동 개선은 모델이 스스로 가중치를 학습한다는 뜻이 아니다. 제품의 실패 신호를 구조화해 수정 후보를 만들고, 기존 평가를 실행하는 엔지니어링 과정의 일부를 자동화하는 것이다.
루프는 네 단계로 나뉜다. - Correction: 사용자가 에이전트의 결과를 수정한다. - Trace: 해당 결과가 만들어진 실행 경로를 복원한다. - Eval: 수정 전의 실패를 재현 가능한 테스트로 바꾼다. - Update: 프롬프트, 검색, 도구, 코드 중 실제 원인에 맞는 변경을 제안하고 회귀 평가를 통과시킨다.
이름만 보면 단순하지만, 각 단계의 계약이 분명하지 않으면 루프가 오히려 잘못된 방향으로 최적화된다. 사용자의 모든 수정이 정답은 아니며, 최종 답이 같더라도 잘못된 권한으로 도구를 호출했다면 성공으로 처리할 수 없다.
사용자 수정에서 실제 오류 가려내기
최종 답변에 대해 좋아요와 싫어요만 받으면 원인을 찾기 어렵다. 가능한 한 수정이 발생한 위치를 함께 기록해야 한다.
다만 예측값과 수정값의 차이만으로 실패를 단정하면 안 된다. 사용자가 표현만 바꿨을 수도 있고, 실행 이후에 원본 데이터가 갱신됐을 수도 있다. 개인정보나 민감한 업무 데이터가 포함된 수정 기록을 그대로 평가 저장소에 복사하는 것도 위험하다.
따라서 첫 단계에는 사람이 직접 확인하는 가벼운 분류 과정이 필요하다. - 제품에서 고쳐야 할 재현 가능한 실패인가 - 일시적인 외부 시스템 오류인가 - 사용자 선호나 표현의 차이인가 - 데이터·정책 변경으로 기존 정답이 낡았는가 - 보안 검토가 필요한 사례인가
첫 번째 자동화 대상은 검토할 만한 실패를 모으는 단계다. 수정값을 곧바로 정답이나 운영 변경 사항으로 채택하지는 않는다.
가령 오전에 실행했을 때는 환불 기간을 7일로 안내했는데, 오후에 사용자가 14일로 고쳤다고 해보자. 오전 정책은 7일이었고 정오부터 14일로 바뀌었다면, 이를 단순한 모델 오답으로 단정할 수 없다. 실행 시각과 정책 버전을 복원한 뒤 ‘당시에도 틀렸는가’와 ‘지금 시점에 낡은 정보인가’를 구분해야 한다. 수정값만 정답으로 저장하면 과거의 올바른 동작을 실패 사례로 학습할 수 있다.
이를 위해 같은 질문에 대해 두 개의 fixture를 만든다. 이전 정책 스냅샷에서는 7일을, 새 정책 스냅샷에서는 14일을 요구하고 유효 시각을 입력으로 제공한다. 검색 결과의 날짜를 무시하고 무조건 더 큰 숫자를 고르는 식의 수정은 두 평가 중 하나에서 실패한다. 이는 실제 세무 서비스 자료가 아니라 평가 설계를 설명하기 위한 가상 예시다.
수정 후보를 검증할 때는 해당 실패를 고쳤는지뿐만 아니라, 이전에 맞혔던 대조 사례를 그대로 유지하는지도 본다. 새 정책을 확인해야 하는 질문과 이미 주어진 정책만으로 충분한 질문을 함께 넣으면, 모든 요청마다 무조건 검색하도록 바꾼 과잉 수정도 걸러낼 수 있다. 정답·금지 행동·비용을 따로 기록해야 특정 지표의 상승이 다른 회귀를 가리지 않는다.
| 필드 | 기록할 내용 |
|---|---|
| 요청 | 자연어 질문과 사용자 역할 |
| 예측 | 생성한 SQL, 조회 결과, 최종 설명 |
| 수정 | 사용자가 고친 SQL 또는 기대한 결과 |
| 환경 | 스키마 버전, 데이터 스냅샷, 모델·프롬프트 버전 |
| 실행 | 도구 호출 순서, 오류, 재시도, 사용 토큰 |
| 판정 | 실제 오류, 취향 차이, 데이터 변경, 권한 문제 |
실행 기록에서 실패 지점 찾기
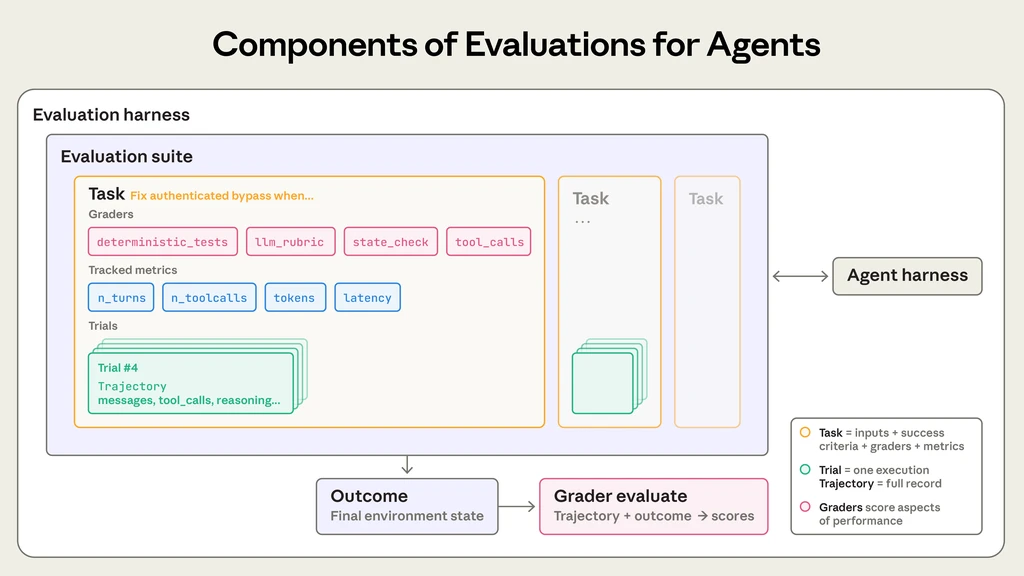
에이전트는 여러 번 도구를 호출하며 환경 상태를 바꾼다. 최종 출력만 저장해서는 어느 지점에서 실패했는지 구분할 수 없다. Anthropic의 에이전트 평가 가이드에서도 한 번의 실행을 출력, 도구 호출, 중간 결과가 모두 포함된 transcript 또는 trace로 정의한다.
실패 분석에는 최소한 다음 이벤트가 필요하다. - run_started - model_called - tool_requested - tool_returned - state_changed - user_corrected - run_finished
각 이벤트에는 run_id, 시각, 모델·도구 버전, 입력 해시, 출력, 지연 시간, 토큰 사용량을 기록한다. 원문을 모두 보존하기 어렵다면 민감 정보는 마스킹하고, 재현에 필요한 데이터는 읽기 전용 스냅샷이나 합성 fixture로 옮긴다.
Trace를 읽을 때는 실패를 하나의 덩어리로 보지 않는다. - 인지 실패: 필요한 정보가 컨텍스트에 없었다. - 판단 실패: 정보는 있었지만 잘못 해석했다. - 도구 실패: 인자, 호출 순서, 재시도 정책이 틀렸다. - 상태 실패: 이전 단계의 값을 잃어버렸거나 오래된 상태를 사용했다. - 검증 실패: 잘못된 결과를 확인하지 않고 종료했다. - 평가 실패: 실제 답은 유효한데 grader가 틀렸다고 판정했다.
이렇게 분류해야 어디를 고칠지 정할 수 있다. 검색 실패를 시스템 프롬프트로 덮으려 하거나 도구 스키마 문제를 모델 교체로 해결하려 들면 비용만 늘어난다.
run_started
model_called
tool_requested
tool_returned
state_changed
user_corrected
run_finished
입력·환경·성공 조건 고정
좋은 실패 사례가 자동으로 좋은 eval이 되는 것은 아니다. 프로덕션 로그는 외부 API, 실시간 데이터, 우연한 재시도에 의존하므로 그대로 재생하면 실행할 때마다 결과가 달라질 수 있다.
따라서 하나의 실패를 평가 항목으로 만들 때는 다음 요소를 고정한다.
입력과 환경: - 사용자 요청과 필요한 이전 대화 - 도구 정의와 권한 - 데이터·파일 fixture - 시간, 지역, 스키마 버전처럼 답에 영향을 주는 상태
성공 조건: - 최종 상태가 맞는가 - 필요한 근거를 사용했는가 - 금지된 도구나 권한을 사용하지 않았는가 - 불필요한 반복 호출 없이 끝냈는가 - 모호한 상황에서 확인 질문을 했는가
최종 문자열이 일치하는지만 보는 평가로는 부족하다. 같은 답도 여러 방식으로 표현할 수 있고, 우연히 맞는 답을 내면서 내부 상태를 망가뜨릴 수도 있기 때문이다. 가능한 항목은 실행 결과나 상태 검사처럼 결정적인 grader로 판정하고, 표현 품질처럼 정답이 열려 있는 부분에만 LLM grader를 쓴다. LLM grader의 판정은 일정 비율을 사람이 다시 확인해 편향을 교정한다.
또한 한 번 성공했다고 해서 바로 통과시키지 않는다. 모델 출력에는 변동성이 있으므로 같은 task를 여러 trial로 실행한다. pass@1만 보지 말고, 반복 실행에서 얼마나 안정적으로 성공하는지도 함께 본다.
개선 목표를 회귀 검사로 전환하기
새로 발견한 문제는 먼저 capability eval에 넣는다. 현재 시스템이 어려워하는 문제를 모아 개선 목표로 삼는 것이다. 이후 수정을 거쳐 안정적으로 통과하기 시작하면 regression eval로 옮긴다. 다음 배포에서 다시 깨지지 않는지 확인하는 안전망이다.
이 구분이 없으면 평가셋이 금방 포화된다. 쉬운 문제만 쌓이면 점수는 높게 나오지만 개선 방향을 알려 주지 못한다. 반대로 실패 사례만 계속 추가하면 원래 잘 작동하던 기능이 망가지는 것을 놓치게 된다.
평가 항목은 양방향으로 구성하는 편이 좋다. 예를 들어 “필요할 때 검색하는가”만 검사하면 에이전트가 모든 요청에서 검색하도록 최적화될 수 있다. 검색이 필요하지 않은 대조 사례도 함께 넣어야 한다.
실패 원인에 맞는 구성요소만 바꾸기
변경은 가능한 한 작게 만든다. 프롬프트, 도구 설명, 검색 정책, 실행 코드를 한꺼번에 바꾸면 무엇이 효과를 냈는지 알 수 없다. 수정 후보마다 변경 이유와 영향을 받을 평가 slice를 기록한다.
배포 전에는 원래 실패의 복구 여부, 기존 기능의 회귀, 운영 예산을 각각 확인한다. - Targeted eval: 원래 실패가 복구됐는가 - Regression eval: 기존에 통과하던 작업이 깨지지 않았는가 - 운영 예산: 지연 시간, 토큰, 도구 호출 수, 사람 검토량이 허용 범위 안에 있는가
고위험 도메인에서는 자동 배포하지 않는다. 수정안 생성과 평가 실행까지 자동화하더라도 코드 병합, 권한 변경, 프로덕션 반영에는 사람의 승인을 거친다. OpenAI 사례에서도 개선 에이전트가 접근하는 프로덕션 증거는 읽기 전용으로 제한하고, 수정 가능한 작업 공간과 분리했다.
| 실패 유형 | 먼저 검토할 수정 위치 |
|---|---|
| 근거를 못 찾음 | 검색 쿼리, metadata filter, reranker, chunking |
| 잘못된 인자 호출 | 도구 이름·설명·스키마, 입력 validation |
| 오래된 상태 사용 | 상태 저장 방식, cache invalidation, context policy |
| 불필요한 반복 | 종료 조건, idempotency key, retry budget |
| 근거 없는 단정 | 출력 스키마, citation 검사, post-condition |
| 권한 초과 | 도구 권한, sandbox, 승인 단계 |
개선 절차 비교 실험안
작은 실험은 Text-to-SQL이나 사내 문서 검색 에이전트로 시작할 수 있다.
데이터셋: - 실제 실패 로그에서 개인정보를 제거한 사례 20~30개 - 각 사례와 같은 유형이지만 표현이 다른 변형 문제 - 수정이 필요하지 않은 대조 문제 - 기존 시스템이 안정적으로 풀던 회귀 문제
비교 조건: - Baseline: 실패가 생길 때마다 사람이 임의로 수정 - Structured loop: correction을 trace와 연결하고 eval로 등록한 뒤 수정안을 검증
두 조건 모두 같은 모델과 도구 버전을 사용한다. 비교 대상은 모델 성능이 아니라 개선 절차다.
측정 항목: - 실패를 재현 가능한 eval로 전환하는 비율 - 같은 유형의 실패가 다시 발생하는 빈도 - targeted eval의 반복 성공률 - regression eval의 하락 여부 - 수정 하나당 조사·검토 시간 - 수정 전후의 토큰, 지연 시간, 도구 호출 수 - grader 판정과 사람 판정의 불일치율
특히 “실패 건수 감소”만 보면 안 된다. 사용자 트래픽 구성이 바뀌면 실패 건수도 달라지기 때문이다. 동일한 평가셋과 트래픽 slice에서 실패율을 비교하고, 새 문제를 숨기기 위해 답변을 회피하는 비율도 함께 확인한다.
루프의 한계
사용자의 수정이 항상 정답이라고 믿을 때 실무자도 실수할 수 있고 조직 내 정책이 서로 충돌할 수도 있다. 수정값에는 출처와 승인 상태를 붙여야 한다. 서로 다른 정답이 들어오면 자동으로 하나를 선택하지 말고 정책 소유자에게 보낸다.
평가셋에 과적합할 때 동일한 문장을 그대로 재생하면 프롬프트가 사례를 암기할 수 있다. 실패 유형을 유지한 변형 문제와 미공개 holdout을 둔다. 수정이 특정 문구가 아니라 실제 원인을 해결했는지 확인한다.
Trace가 너무 많고 읽기 어려울 때 모든 토큰을 저장하는 것만으로는 관측 가능성이 생기지 않는다. 도구 호출, 상태 변경, 오류, 사용자 수정이 하나의 타임라인에서 이어져야 하며, 실행마다 버전과 비용을 비교할 수 있어야 한다.
자동 수정 권한이 너무 넓을 때 평가 통과가 보안 검토를 대신하지는 않는다. 에이전트가 프롬프트뿐 아니라 도구 권한이나 프로덕션 코드까지 바꿀 수 있다면 영향 범위가 커진다. 읽기 전용 증거, 격리된 작업 공간, 제한된 변경 범위, 사람 승인 순으로 경계를 둔다.
판단 기준
이 구조를 도입할 가치는 반복되는 실패의 비용으로 판단할 수 있다. - 동일한 유형의 실패가 여러 사용자에게 반복되는가 - 실행 경로가 길어 최종 출력만으로는 원인을 찾기 어려운가 - 수정 후 회귀 여부를 사람이 매번 확인하고 있는가 - 사용자 수정 데이터에 정답에 가까운 도메인 신호가 있는가 - 재현 환경과 읽기 전용 증거를 만들 수 있는가
실패가 드물고 작업이 단순하다면 수동 분석과 작은 회귀 테스트로도 충분하다. 반대로 상태와 도구가 얽힌 장기 작업이라면, correction을 eval로 바꾸는 파이프라인 자체가 제품의 자산이 된다.
실패 한 건을 평가로 연결하기
사람이 확인한 correction 한 건과 해당 trace를 연결하는 것부터 시작한다. 입력·환경·성공 조건을 고정해 재현한 뒤 수정 후보를 평가한다. 이후 후보 생성과 평가 실행을 자동화하되, 운영 배포와 정책 판단의 승인 경계는 그대로 유지한다.
참고 자료
Building self-improving tax agents with Codex — OpenAI (https://openai.com/index/building-self-improving-tax-agents-with-codex/ (새 창))
Demystifying evals for AI agents — Anthropic (https://www.anthropic.com/engineering/demystifying-evals-for-ai-agents (새 창))