워터마크 검출은 왜 저자 증명이 아닐까: 오탐과 미검출의 해석
텍스트 표식과 파일 출처 서명의 검증 범위를 나눈다. 가상의 탐지율·오탐률 계산을 통해 양성 결과와 특정 사람의 저자 책임 사이에 남는 간격을 설명한다.
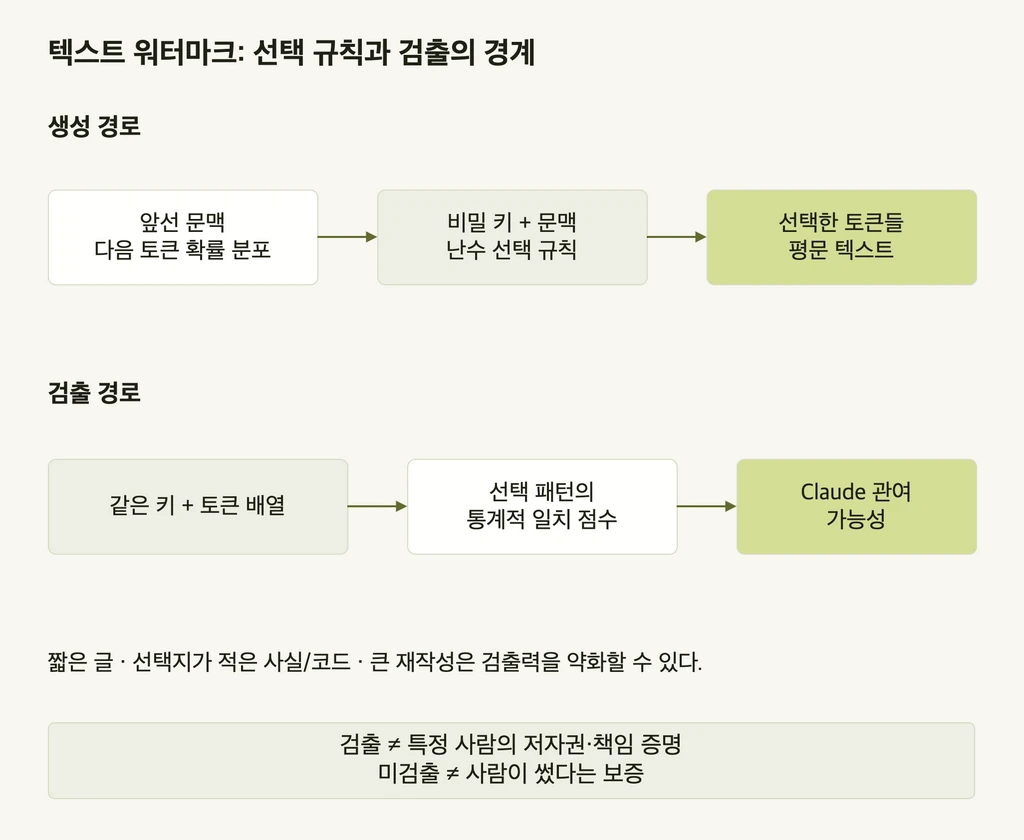
Anthropic은 2026.08.14 앞으로 출시할 Claude 모델에 Google DeepMind의 SynthID-Text 변형을 적용한다고 발표했다. 텍스트를 생성할 때 비밀 키와 앞선 문맥을 반영해 긴 글에 패턴을 남기는 방식인데, 워터마크가 검출되지 않았다고 해서 사람이 쓴 글이라는 뜻은 아니다.
생성 때 적용한 선택 규칙을 검출 때 다시 계산한다
Claude는 문자 자체가 아니라 단어를 고르는 확률에 워터마크 흔적을 남긴다. 생성 시점에는 비밀 키로 token 선택의 무작위성을 제어하고, 검출 시점에는 같은 키를 써서 실제 token 배열이 그 규칙과 얼마나 맞아떨어지는지 점수를 매긴다. 덕분에 텍스트를 복사해 붙여 넣어도 평문 자체에 패턴이 남는다.
Anthropic은 Claude에 SynthID-Text 변형을 쓴다는 설계 원칙만 공개했을 뿐 키, 문맥 길이, sampling 설정, 검출 임계값과 오류율은 밝히지 않았다. 구체적인 메커니즘은 Anthropic의 공식 발표와 Google DeepMind의 2024년 Nature 논문 및 공개 구현을 따른다.
어느 모델과 제품에 적용되는가
Anthropic의 2026.08.14 발표는 향후 출시될 Claude 모델을 대상으로 한다. Help Center에 따르면 EU에서 2026.08.02 이후 출시되는 새 Claude 모델은 출시 시점부터 machine-readable marking을 지원하며, 이전 모델에는 전환 기간에 맞춰 순차적으로 적용된다. 따라서 기존의 모든 Claude 응답에 워터마크가 들어가 있지는 않다.
Anthropic은 지역별 분리 적용이 아직 불가능해 새 모델을 출시할 때 전 세계에 일괄 적용한다고 밝혔다. Claude, Claude Platform API, Claude Code 등 지원 제품과 AWS·Google Cloud·Microsoft Foundry를 통한 모델 출력이 모두 포함되지만, 플랫폼별 C2PA provenance metadata 지원 범위는 다를 수 있다.
SynthID-Text가 단어 선택에 패턴을 남기는 법
LLM은 앞선 문맥을 바탕으로 다음 token의 확률 분포를 만든다. 정답이 하나로 정해진 구간도 있지만, “흐렸다”와 “잿빛이었다”처럼 의미와 품질이 비슷한 후보가 여럿인 구간도 있다. 일반적인 sampling은 이 분포에서 난수를 이용해 하나를 고른다.
SynthID-Text는 이 난수의 출처를 바꾼다. 비밀 키와 직전 몇 개 token의 문맥으로 의사난수 값을 만들고 후보 token마다 g-value를 계산한다. Nature 논문에 소개된 Tournament sampling은 원래 분포에서 후보들을 뽑은 뒤 g-value가 높은 후보를 단계적으로 추려낸다. 모델이 고려하지 않던 단어를 억지로 끼워 넣는 대신, 선택 가능한 후보들 중에서 무엇을 고를지를 키와 문맥에 연결하는 것이다.
검출기는 텍스트를 다시 token으로 나눈 뒤 같은 키와 문맥을 써서 각 위치의 g-value를 다시 계산한다. 원문의 단어 선택이 키가 만든 패턴과 우연 이상으로 자주 일치하면 워터마크가 들어 있을 가능성이 높아진다. 공개된 SynthID-Text 구현은 weighted mean과 Bayesian detector를 제공하는데, Bayesian detector는 해당 키로 생성한 watermarked·unwatermarked 데이터로 별도 학습을 거쳐야 한다. 2026.09.22 기준 Help Center에 따르면 워터마크 검출 API는 규제기관·연구기관 등 자격을 갖춘 조직을 대상으로 비공개 미리보기(private preview) 단계에 있다.
선택지가 좁을수록 워터마크도 옅어진다
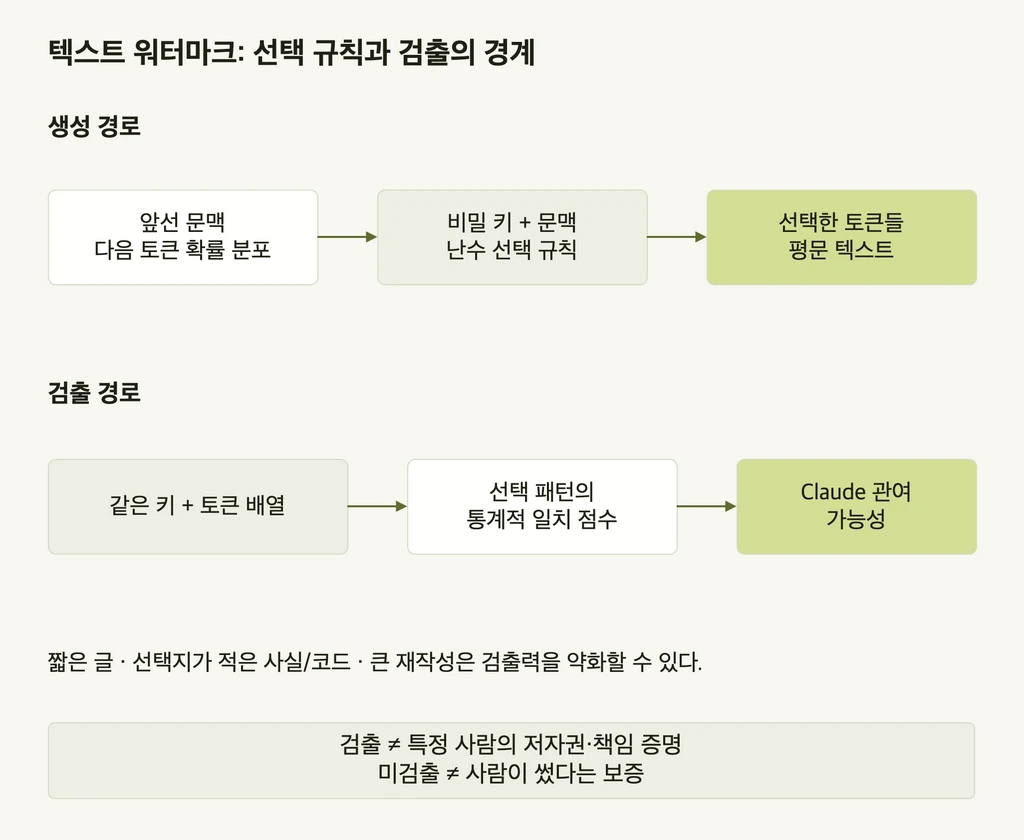
통계적 신호는 선택지가 있어야 생긴다. “Isaac Newton의 대표 저서는 Principia…” 다음 이어질 내용처럼 사실상 정답이 정해진 문장에서는 다른 token을 고르면 정확도가 떨어지므로 워터마크를 강하게 넣을 수 없다. 짧은 글 역시 관측할 수 있는 선택 횟수가 적어 검출 신뢰도가 낮다.
코드도 같은 제약을 받는다. 문법, 식별자, API 이름, 계산 결과처럼 정확한 값이 필요한 자리에는 임의로 선택할 여지가 적다. 주석이나 변수명에는 신호가 남을 수 있지만 코드 전체의 워터마크 밀도는 일반 산문보다 낮다. 맞춤법만 고치는 proofread 작업도 Claude가 새로 고른 단어가 적으면 검출되지 않을 수 있다. 반면 번역은 출력되는 거의 모든 단어를 Claude가 고르므로 워터마크 적용 대상이 된다.
파일의 C2PA는 텍스트 워터마크가 아니다
평문에서 검출하는 통계 패턴과 파일에 붙는 서명은 서로 다른 판정 도구다. 공식 자료 1 (https://www.anthropic.com/news/claude-text-watermark (새 창)) · 공식 자료 2 (https://support.claude.com/en/articles/16266773-how-claude-marks-ai-generated-content (새 창))
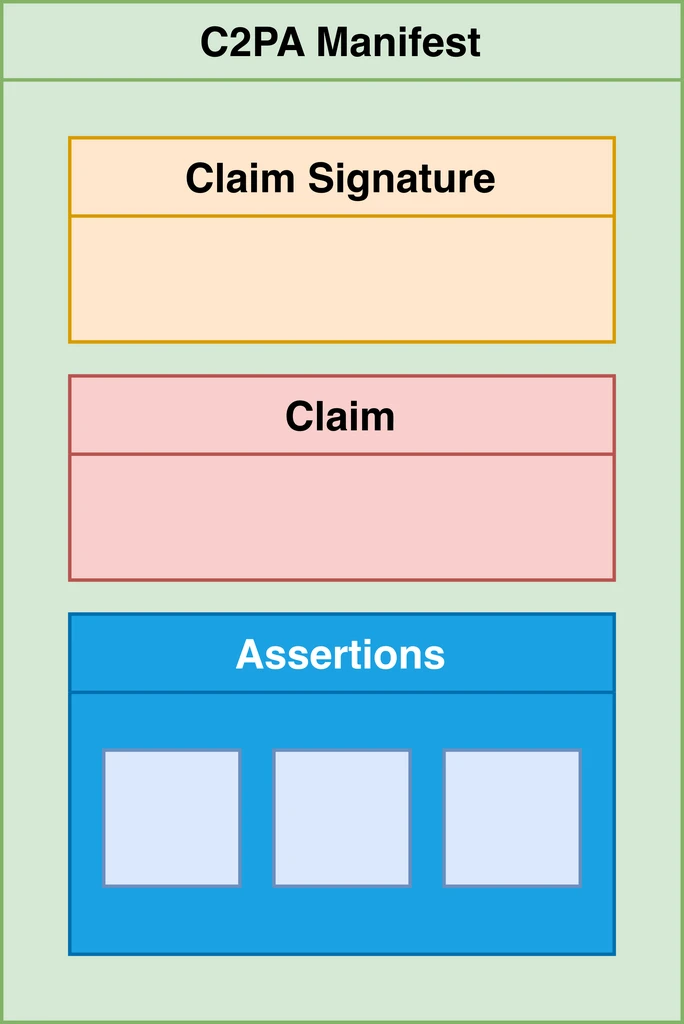
Claude가 지원 형식의 PNG·JPG·SVG 파일을 만들 때는 작은 암호학적 서명이 담긴 C2PA content credential을 metadata에 붙인다. C2PA-aware 도구는 이 서명을 읽어 Claude가 파일을 생성·처리했다는 이력과 변조 여부를 확인한다.
C2PA는 파일 내용 자체의 token 선택을 바꾸지 않으며, 파일을 다시 저장·변환하거나 screenshot을 찍어 metadata가 지워지면 함께 사라질 수 있다. 반면 평문 텍스트에 적용된 SynthID-Text는 복사해 붙여 넣은 뒤에도 남지만, 글을 크게 고치거나 다른 텍스트와 섞으면 약해진다. 두 방식 모두 Claude가 관여했을 가능성을 표시할 뿐 사람의 저자권이나 법적 책임, 내용의 정당성을 증명하지는 않는다.
| 구분 | 담는 정보 | 검증 범위 |
|---|---|---|
| SynthID-Text | 단어 선택의 통계 패턴 | 키를 이용한 전용 검출로 Claude 관여 가능성 확인 |
| C2PA | 서명된 출처 메타데이터 | 서명과 콘텐츠의 연결 확인 |
품질 영향에 관한 근거를 읽는 법
Anthropic은 내부 시험 결과 content, creativity, readability에서 실질적인 저하가 없었다고 밝혔으나 세부 데이터는 공개하지 않았다. 외부에서 확인할 수 있는 대규모 근거는 SynthID-Text Nature 논문이다. Google DeepMind는 약 2,000만 개의 Gemini watermarked·unwatermarked 응답을 비교한 결과 thumbs-up 차이 0.01%, thumbs-down 차이 0.02%로 통계적 유의성이 없다고 보고했다.
다만 이는 Gemini의 배포 결과이므로 Claude의 품질 검증 수치로 그대로 대입할 수는 없다. Claude에서의 실제 영향은 모델 버전, 언어, temperature, 글 길이, 코드 비중에 따라 달라질 수 있으므로 공개 검출 API와 별도 평가 자료로 확인해야 한다.
검출 결과를 운영에 쓸 때 확인할 조건
콘텐츠 운영자는 워터마크 검출 결과를 저자 판정이나 제재의 단독 근거로 써서는 안 된다. 워터마크가 검출되었다는 것은 Claude가 관여했을 가능성을 뜻하며, 여기에는 proofread·translation·summarization처럼 사람이 쓴 원문을 다듬거나 처리한 경우도 포함된다. 반대로 검출되지 않았다고 해서 사람이 썼다는 보증이 되지도 않는다.
API 사용자는 표식이 적용된 모델 버전을 기록해 두어야 한다. 짧은 답변·사실 문장·코드는 검출력이 낮고, 재작성·번역·부분 인용·외부 텍스트 혼합은 신호를 약화시킨다. 파일을 변환하는 과정에서 C2PA 메타데이터가 유지되는지도 별도로 시험해야 하며, 향후 검출 API 접근이 확대되면 임계값·오탐률·지원 언어·최소 길이를 확인해야 한다.
검출기의 수치가 공개되더라도 양성 결과를 곧바로 저자 판정으로 직결할 수는 없다. 가령 문서 10,000개 중 표식 대상이 100개이고 탐지율이 90%, 나머지 문서의 오탐률이 1%라고 가정해 보자. 참양성은 90개, 거짓양성은 99개이므로 양성 판정을 받은 189개 중 실제 대상은 약 47.6%에 그친다. 이는 Claude의 비공개 성능을 추정한 값이 아니라 기저율과 오탐이 판정에 미치는 영향을 보여주는 가상 계산이다.
반대로 이 예시에서 표식 대상 문서 10개는 검출되지 않는다. 미검출 자료를 모두 사람이 작성했다고 분류하면 이 10개부터 틀리게 된다. 실제 판정을 내리려면 지원 모델·언어·길이·혼합 정도와 임계값별 오류율이 필요하다. 검출 점수가 높게 나오더라도 누가 프롬프트를 썼는지, 어떤 문장에 사람이 기여했는지, 공개를 승인했는지는 별도 기록 없이는 알 수 없다.
출처를 관리할 때는 생성·수정 이력과 검출 결과를 서로 다른 항목으로 나누어 저장한다. 예를 들어 사람이 쓴 원문을 모델이 번역한 문서라면 ‘모델 관여’와 ‘원문의 저자’가 동시에 성립한다. 워터마크 하나로 이 두 역할을 뭉뚱그리지 않고 원문·변환 단계·승인 기록을 연결해 두어야 콘텐츠 책임을 검토할 근거가 남는다.
Claude의 검출 성능은 아직 확인할 부분이 남았다
Anthropic은 키와 운영 매개변수, 오류율을 공개하지 않았고 검출 API도 제한된 조직에만 비공개 미리보기로 제공한다. 따라서 운영 정책을 세울 때는 검출과 미검출의 의미를 명확히 구분하고, 이를 저자·소유권·책임 판정의 단독 근거로 삼지 않아야 한다.
참고 자료
Anthropic: How Claude’s text watermark works (새 창)
Claude Help Center: How Claude marks AI-generated content (새 창)
Nature: Scalable watermarking for identifying large language model outputs (새 창)
Google DeepMind: SynthID Text reference implementation (새 창)
European Commission: Code of Practice on Transparency of AI-generated Content (새 창)