Gemma 4 초안 토큰이 많이 거절될 때: 수락률과 실제 가속 조건
드래프트 생성·검증 비용을 확정 토큰 수로 나눠 비교하고, 초안 길이를 늘려도 빨라지지 않는 조건을 설명한다.
소배치 디코딩에서 초안 생성과 검증을 나누는 이유
토큰마다 큰 모델을 읽는 비용
단일 요청 같은 소배치(small-batch) 디코딩에서는 메모리 대역폭이 병목이 되기 쉽다. 토큰 하나를 생성할 때마다 수많은 파라미터를 VRAM에서 연산 장치로 옮겨야 해서 정작 계산 자원을 충분히 활용하지 못한다.
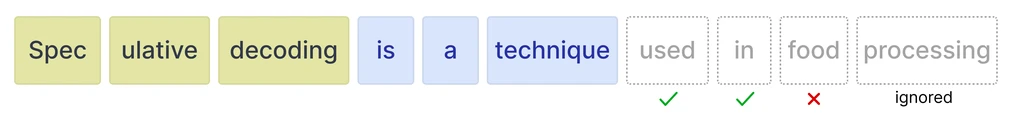
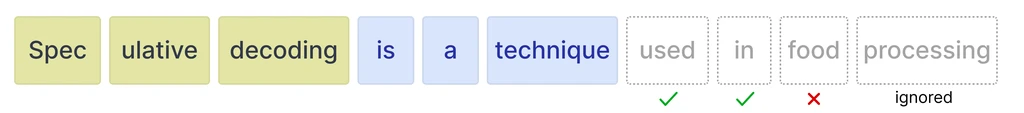
"Actions speak louder than…" 뒤에 오는 "words"처럼 예측하기 쉬운 토큰도 전체 모델을 거쳐야 한다. 작은 모델이 후보를 먼저 만들고 큰 모델이 한꺼번에 검증하면 반복 비용을 줄일 수 있다.
여러 후보를 만든 뒤 타겟 모델로 검증하기
Speculative Decoding은 토큰 생성과 검증을 분리한다. 무거운 타겟 모델(예: Gemma 4 31B)과 경량 드래프터(MTP 모델)를 짝지으면, 타겟 모델이 토큰 하나를 처리하는 시간보다 빠르게 드래프터가 여러 후보 토큰을 자동회귀적으로 예측한다. 타겟 모델은 제안된 토큰들을 한 번에 병렬로 검증한다.
검증 결과는 두 갈래로 나뉘며, 이 검증 과정이 품질 손실을 막는 핵심 메커니즘이다. 단, 타겟 분포를 그대로 유지하려면 정확한 수락·거부 기준과 샘플링 보정을 구현해야 하며, 단순히 확률이 높다고 수락하는 방식으로는 무손실을 보장할 수 없다.
활성화·KV 캐시 재사용과 엣지 모델 최적화
드래프트 모델은 타겟 모델의 활성화(activations)와 KV 캐시를 공유해 이미 처리한 컨텍스트의 중복 계산을 줄인다.
E2B 및 E4B 엣지 모델에서는 최종 logit 계산이 주요 병목이므로, 임베더(embedder)에 클러스터링 기법을 적용해 생성 속도를 추가로 높였다.
속도 검증이 필요한 사용 환경
코딩 보조, 다단계 계획, 온디바이스 앱처럼 디코딩 지연이 중요한 환경에서 효과가 크다. 다만 서비스 병목이 다른 구간에 있다면 디코딩이 빨라져도 전체 응답 시간은 크게 줄지 않을 수 있다.
[타겟 모델 동의 시]
드래프트 시퀀스 전체 수락 + 타겟 모델이 추가 토큰 1개 생성
→ 1회 forward pass로 N+1개 토큰 출력

[타겟 모델 불일치 시]
불일치 직전까지의 토큰만 수락, 타겟 모델 토큰으로 대체 후 재드래프팅
→ 올바른 검증·샘플링 구현에서 타겟의 생성 분포 보존| 환경 | 속도 향상 |
|---|---|
| 전반적 | 최대 3x |
| Apple Silicon의 26B MoE (Batch 4~8) | 약 2.2x |
| NVIDIA A100 (Batch 증가 시) | 유사한 향상 |
| 적용 프레임워크 | LiteRT-LM, MLX, HuggingFace Transformers, vLLM |
공식 동작과 구현별 확인 사항
전체 아키텍처
핵심 루프 로직
[드래프팅 단계]
[검증 단계]
[KV 캐시 공유 전략]
[엣지 디바이스 최적화: Embedder 클러스터링]
[배치 처리 전략]
┌──────────────────────────────────────────────────┐
│              Speculative Decoding System          │
│                                                  │
│  ┌────────────────┐      ┌───────────────────┐   │
│  │  MTP Drafter   │─────▶│  Target Model     │   │
│  │  (경량, 빠름)  │ 초안  │  (Gemma 4 Full)   │   │
│  │                │      │  (검증, 느림)      │   │
│  └────────────────┘      └───────────────────┘   │
│         │                        │               │
│    공유 KV Cache ◀──────────────────┘             │
│    공유 Activations                              │
└──────────────────────────────────────────────────┘입력: 현재까지의 컨텍스트 (타겟 모델 KV 캐시 재활용)
1. MTP Drafter가 K개 토큰을 자동회귀적으로 예측 (K는 설정값)
- 타겟 모델의 activations를 활용
- KV 캐시 공유로 컨텍스트 중복 계산을 줄임
- 경량 구조로 K개 토큰을 빠르게 초안 작성하는 것이 목표
2. 예측된 K개 토큰 후보 시퀀스 생성입력: 현재 컨텍스트 + K개 드래프트 토큰
1. 타겟 모델이 K+1 위치 전체를 병렬 forward pass
(K개 드래프트 토큰 + 다음 1개 위치 동시 처리)
2. 각 위치별 타겟 모델 확률 분포 vs 드래프터 예측 비교
3. 수락/거부 결정 (위치별 순서대로):
- 수락: 타겟 모델 동의 → 다음 위치로
- 거부: 해당 위치에서 타겟 모델 토큰으로 대체 → 루프 재시작
4. 드래프트 수락 수는 0~K개, 타겟 생성 1개를 포함한 출력은 1~K+1개공식 소개에서 확인한 내용:
- 드래프터가 타겟 모델의 activations와 KV 캐시를 활용
- 타겟이 이미 처리한 컨텍스트의 중복 계산을 줄임
- 여러 후보의 검증을 한 forward pass에서 수행
캐시의 소유권·거부 후 잘라내기·갱신 범위는 구현마다 확인해야 한다.
드래프터 캐시만 무효화하면 된다고 가정하거나 재계산 비용을 0으로 단정하지 않는다.공식 소개는 E2B/E4B의 최종 logit 계산 병목을 줄이기 위해
embedder에 clustering을 적용했다고 설명한다.
이 글에서 확인한 자료만으로 군집의 의미적 기준이나 세부 연산 순서를 확정하지 않는다.단일 요청 (Batch=1):
- 메모리 대역폭 병목 상태
- 26B MoE에서 라우팅 관련 어려움이 보고됨
다중 요청 (Batch=4~8):
- 유휴 컴퓨팅 자원 활용 극대화
- GPU 행렬 연산 효율 향상
- 26B MoE·Apple Silicon에서 최대 약 2.2x 보고
실무 적용: 서버 환경은 배치 크기 최적화가 핵심 튜닝 포인트수락률과 추가 메모리를 측정할 검토안
아래 항목은 실무 도입 시 점검할 가설과 최적화 방향이다.
도메인·초안 길이·장치별 비용 검토
① 드래프트 수락률(Acceptance Rate)의 도메인 의존성
② K값 고정 비효율
③ 드래프터 학습 방식 개선 여지
④ 멀티모달 확장
⑤ 온디바이스 배포 관점
현재:
  - 수락률이 높을수록 속도 향상 (당연)
  - 하지만 수락률은 입력 분포에 민감

문제:
  - 창의적 글쓰기, 코드 생성, 수학 추론마다 수락률 편차 큼
  - 드래프터가 특정 도메인에 편향 학습 시 타 도메인 성능 저하

개선 방향:
  - 도메인별 전문 드래프터 앙상블 (라우터 기반 선택)
  - 런타임 수락률 모니터링 → 동적 K값 조정
(수락률 높으면 K 증가, 낮으면 K 감소)공식 Transformers 문서는 K를 고정하는 constant와 동적 heuristic을 모두 지원함
문제:
- 초반 컨텍스트 풍부 시 수락률 높음 → K 크게 잡아야 유리
- 복잡한 추론 구간 → 수락률 낮음 → K 작아야 유리
- 고정 K가 특정 입력에서 비효율적인지 실측해야 함
개선 방향:
- 기본 heuristic: 전체 수락 시 K를 2 증가, 일부 거부 시 1 감소
- 수락률 임계값 기반으로 K를 실시간 증감
- 강화학습으로 K 정책 최적화미확인 사항:
- 이 글에서 검토한 소개·사용 문서만으로 학습 손실을 확정하지 않음
- 타겟의 거부 패턴을 학습에 반영하지 않았다고 단정할 근거도 없음
개선 방향:
- Co-training: 타겟 모델의 거부 신호를 드래프터 학습에 피드백
- Rejection-aware Loss: 거부된 위치에 높은 패널티 부여
- 타겟 모델 output distribution을 증류(distillation) 타겟으로 활용검토 범위: 공식 사용 예제의 텍스트 토큰 생성
Gemma 4가 멀티모달 지원 모델이므로:
- 이미지 패치 토큰 드래프팅 가능성
- 오디오 프레임 예측에도 동일 원리 적용 가능
- 단, 모달리티별 토큰 예측 난이도가 달라 별도 드래프터 필요현재 과제:
- 26B MoE의 Apple Silicon Batch=1 라우팅 비용을 별도 측정
- 모바일 디바이스 메모리 제약으로 드래프터 + 타겟 동시 로드 부담
개선 방향:
- 드래프터를 NPU 전용으로 경량화 (타겟은 GPU)
- 이기종 연산 스케줄링 최적화
(장치 간 상태 전달 비용과 의존성을 포함해 검증할 연구 아이디어)
- 드래프터 양자화(4-bit/8-bit)로 메모리 공간 최소화도입 전 같은 작업으로 비교하기
동일한 타겟 모델과 입력 조건에서 드래프터 사용 여부, 배치 크기, 초안 길이(K)를 바꿔가며 수락률·전체 지연 시간·메모리 사용량을 함께 측정한다. 단순 가속 배율보다 실제 서비스 병목이 줄었는지, 수락·거부 구현이 타겟 모델의 출력 분포를 정확히 보존하는지가 핵심 판단 기준이다.
가상 실행에서 타겟 모델이 토큰 하나를 확정하는 데 20ms가 걸린다고 하자. 드래프트 생성에 8ms, 묶음 검증에 24ms를 써서 한 주기에 총 4토큰을 확정하면 토큰당 8ms가 걸려 기준선보다 2.5배 빠르다. 그러나 같은 32ms 동안 첫 후보부터 거절돼 총 1토큰만 확정하면 토큰당 32ms로 오히려 더 느려진다. 이 수치는 Gemma 4 실측값이 아니라 가속 조건을 계산하는 예시다.
분모에는 제안한 후보 개수가 아니라 보정 토큰을 포함해 실제로 확정한 토큰 수를 넣어야 한다. 초안 길이를 늘리면 수락될 기회도 늘지만 드래프트 및 검증 비용과 임시 캐시도 함께 늘어날 수 있다. 같은 입력 묶음에서 주기별 확정 토큰과 시간을 합산해 비교하고, 수락률만 높았던 요청을 골라 전체 가속 효과인 것처럼 보고하지 않는다.
출력 분포 보존과 속도 개선은 별도로 검사한다. 결정적 디코딩에서는 출력이 같은지 확인할 수 있지만, 확률적 샘플링에서는 단일 출력이 달라졌다는 이유만으로 분포가 바뀌었다고 단정할 수 없다. 반대로 몇 문장이 같다고 해서 수락·거부와 잔여 분포 계산이 정확하다는 증거가 되지도 않는다. 구현된 샘플링 규칙을 검증하고 장치·배치별 성능은 따로 측정한다.
참고 자료
Accelerating Gemma 4: faster inference with multi-token prediction drafters — Google (https://blog.google/innovation-and-ai/technology/developers-tools/multi-token-prediction-gemma-4/ (새 창))
Gemma 4 Multi-Token Prediction 사용 문서 — Google AI for Developers (https://ai.google.dev/gemma/docs/mtp/mtp (새 창))