토큰을 지웠는데 GPU 메모리는 그대로인 이유: vToken의 블록 회수
16슬롯 중 토큰 12개를 지워도 네 블록이 모두 남을 수 있다. vToken이 논리 토큰과 물리 슬롯을 분리해 빈 블록을 만드는 과정과 재배치가 이득 없는 조건을 설명한다.
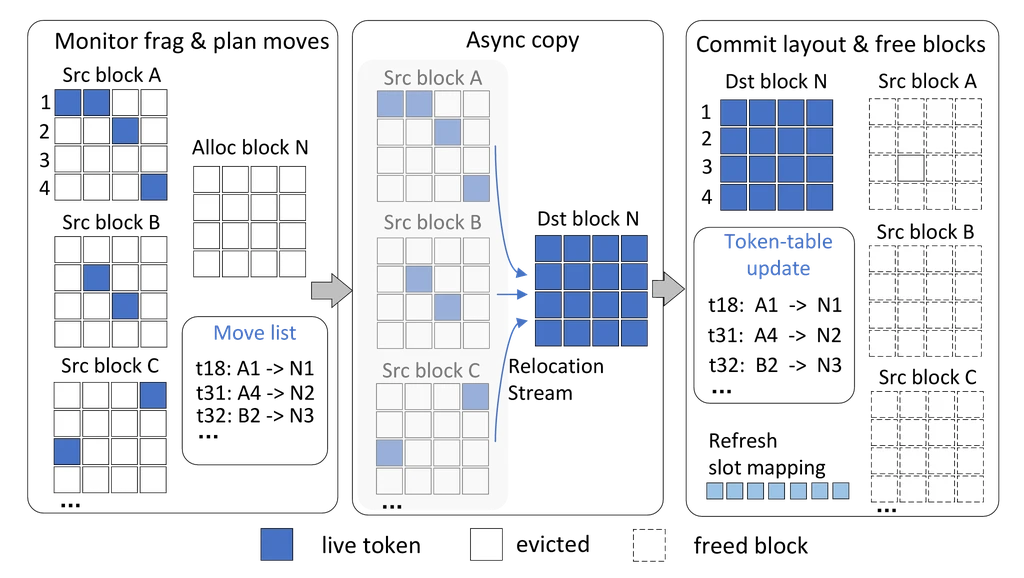
KV cache에서 토큰을 지워도 같은 블록에 다른 토큰이 남아 있으면 GPU 메모리를 반환할 수 없다. 2026년 8월 13일 공개된 vToken은 이러한 단위 불일치(granularity mismatch)를 해결해 논리적 제거가 실제 블록 회수로 이어지게 한다.
eviction policy에는 논리 토큰의 생존 여부만 노출하고, 런타임이 token-table indirection과 asynchronous repacking으로 살아남은 토큰을 재배치한다. 논문 초록은 요청당 유지되는 KV 블록을 27.2%~72.3% 줄이고 SLA 제약 처리량을 최대 1.37배 높였다고 요약하며, 본문의 일부 추가 조건에서는 더 큰 향상 폭도 제시한다.
GPU 서빙 부하 시험과 도입 기준
생성·임베딩 모델 GPU 서빙 프로젝트에서는 듀얼 GPU 환경에서 생성 100건과 이미지 포함 8K 임베딩 100건의 복합 부하를 시험했다. 그 결과 동시성 256은 128보다 처리량이 0.5% 낮고 지연이 길어 128을 선택했다.
vToken은 기본 실행 조건에서 메모리 압력이 관측될 때 이식 복잡도와 함께 검토할 후보로, 실제 반환된 GPU 블록과 지연·처리량 변화로 도입 가치를 판단해야 한다.
토큰 제거와 블록 반환 사이의 간격
블록 단위로 메모리를 관리하는 구조에 토큰 단위의 제거 정책을 얹으면, 일부만 사용 중인 블록이 남게 된다. 논리 주소와 물리 슬롯을 분리하고 살아 있는 토큰을 한데 모아야 빈 블록을 재사용할 수 있다.
vToken은 제거 대상을 고르는 새로운 정책이 아니다. H2O·Random·Scissorhands 같은 정책이 남길 토큰을 정하면, 이를 PagedAttention의 물리 블록 회수로 연결하는 실행 계층이다.
가상으로 한 블록에 토큰이 4개씩 들어가고, 네 블록마다 토큰이 하나씩만 살아 있다고 해보자. 전체 16슬롯 중 4슬롯만 유효하므로 정책은 토큰의 75%를 지운 셈이다. 하지만 네 블록 모두 생존 토큰이 남아 있어 할당된 블록은 하나도 반환하지 못한다. 생존 토큰 4개를 한 블록으로 모아야 나머지 3블록을 반환할 수 있다. 이처럼 “75% 제거”와 “3블록 회수” 사이를 메우는 작업이 바로 재배치다. 이는 이해를 돕기 위한 가상 예시로, 실제 블록 크기나 논문 성능을 나타낸 수치는 아니다.
vLLM과 지정된 메모리·SLA 조건의 평가
vToken은 vLLM 위에 구현됐으며, Mistral-7B, Llama-3.1-8B, Qwen2.5-14B(capacity frontier 확인용) 모델과 ShareGPT, LongBench 워크로드에서 H2O, Random, Scissorhands 정책을 적용해 평가됐다.
비교 기준인 Naive-Evict는 토큰을 논리적으로만 제거할 뿐, 일부 토큰이 남은 블록을 적극적으로 압축하지는 않는다. 실험 결과는 fp16 KV, PagedAttention 계열 런타임과 지정된 SLA·active-KV budget 조건을 기준으로 삼는다.
논리 주소를 유지하면서 물리 배치를 바꾸기
PagedAttention은 KV cache를 고정 크기 block으로 관리해 allocator 수준의 fragmentation을 줄인다. 하지만 token별 attention score나 persistence를 보고 제거하는 정책을 쓰면, 한 block 안에서 일부 token만 지워져 block이 계속 할당된 채로 남는다.
vToken에서 제거 정책은 evict_token 같은 인터페이스로 토큰의 생존 여부만 바꿀 뿐, 물리 블록 위치는 직접 관리하지 않는다. 대신 token table이 논리 인덱스를 현재 슬롯에 연결해 attention 커널이 참조하는 순서를 유지한다.
회수 이익이 충분하다고 판단되면 런타임은 남은 토큰을 다른 블록의 빈 슬롯으로 비동기 복사하고, 슬롯 매핑을 갱신한 뒤 빈 블록을 반환한다. 이 과정에서 CUDA Graph와 기존 PagedAttention 커널은 그대로 유지하며, attention이 옮겨진 값을 읽기 전에 복사가 끝났는지 확인하고 기다린다. 복사는 attention과 HBM 대역폭을 두고 경쟁하지 않도록 실행 단계에 맞춰 배치한다.
위 예시에서 논리 토큰 5가 물리 블록 B의 슬롯 1에 있다고 하자. 이를 블록 A의 빈 슬롯 2로 옮긴 뒤에는 token table의 토큰 5 항목을 A:2로 바꾼다. 토큰의 논리적 정체성과 실제 저장 위치를 분리했기 때문에, 제거 정책은 토큰 5의 중요도만 판단하면 된다. 이후 attention 실행에는 갱신된 슬롯 매핑이 전달된다.
복사를 요청한 시점과 실제로 복사가 끝나는 시점은 다르다. 새 위치에 값이 준비되기 전에 매핑을 바꾸거나, 이전 실행이 아직 읽고 있는 블록을 먼저 반환해 버리면 다른 토큰의 KV를 잘못 읽을 수 있다. 따라서 복사 완료, 매핑 사용, 블록 재사용 사이의 의존성을 지켜야 한다. 여기서 비동기란 이 순서를 무시한다는 뜻이 아니라, 안전한 의존성 안에서 복사와 계산이 겹치도록 스케줄링한다는 의미다.
성능 수치와 조건
같은 정책을 쓴 Naive-Evict와 비교했을 때, vToken은 요청당 유지되는 KV 블록(retained KV block)을 27.2%~72.3% 줄였다. Random처럼 생존 토큰이 여러 블록에 흩어지는 정책에서 이득이 가장 컸고, H2O처럼 비교적 구조화해 보존하는 정책에서도 유지 블록 수가 줄었다.
초록과 결론에서는 SLA 만족 지점의 처리량 향상을 최대 1.37배로 요약하지만, 본문 5.3절의 Scissorhands 결과를 보면 33.3%~103.7% 향상도 나타나므로 모델·정책별 세부 결과를 따로 확인할 필요가 있다. constrained active-KV budget 조건에서는 특정 모델·워크로드·정책 조합에서 최대 동시성(concurrency)이 2배까지 늘었다.
런타임이 물리 배치를 맡으면서 정책 통합 코드도 block manager 여러 파일에 걸친 500줄 이상에서 50줄 미만으로 줄어들어, 정책 구현자는 토큰 중요도 판단에만 집중할 수 있다.
언제 도입할 가치가 있나
vToken은 토큰 제거가 실제 용량 회수로 이어져야 하는 메모리 압력 상황에서 작동하는 확장(pressure-activated extension)이다. 메모리 압력이 낮은 기본 경로나 짧은 context, 낮은 동시성 환경에서는 repacking과 indirection에 드는 복잡도가 이익보다 커 Native vLLM을 쓰는 편이 더 적합하다.
실제 도입할 때는 논리적으로 지운 토큰 수뿐만 아니라 부분 사용 블록 비율, 반환 블록 수, 복사 트래픽, decode p95를 함께 측정해야 실질적인 회수량을 파악할 수 있다. 접두사를 많이 공유하는 서비스라면 공유 블록을 보수적으로 제외하는 현재 구현의 영향도 함께 살펴야 한다.
토큰을 옮겨도 회수할 블록이 없는 경우도 계산해 볼 수 있다. 네 블록에 생존 토큰이 각각 4, 4, 4, 1개 남았다면 총 13개다. 블록당 4개를 담으려면 최소 4블록이 필요하므로, 토큰을 옮겨도 반환할 수 있는 블록이 없다. 반대로 블록마다 1개씩만 남은 앞의 예시는 1블록이면 충분하다. 같은 토큰 제거 정책을 쓰더라도 생존 토큰의 배치와 남은 양에 따라 회수 가능성이 달라지므로, 매번 압축하기보다 실제 반환 이익과 복사 비용을 비교해야 한다.
공유 접두사와 다른 런타임의 이식 조건
현재 구현은 단일 runtime KV cache group을 사용하며 shared-prefix block을 보수적으로 제외한다. tensor parallel 환경에서는 shard별 block pool과 relocation 조정이 추가로 필요하며, 다른 런타임으로 이식하려면 block 할당·해제 hook, attention 실행 전 slot-map 갱신, 비동기 KV copy와 dependency tracking 기능을 갖춰야 한다.
도입 여부를 비교할 때는 단순히 제거한 토큰 수보다 실제 반환한 GPU 블록 수와 SLA 내 처리량을 우선 확인해, 메모리 회수 이익이 재배치 및 주소 간접 참조 비용을 상쇄하는 조건에만 적용한다.