음성 인식 오류는 왜 줄었나: WER 계산부터 파인튜닝 비교 기준까지
WER을 단어 정렬 예제로 직접 계산하고, NVIDIA 음성 인식 사례의 62%와 45.8%가 서로 다른 이유를 설명한다. 합성 라벨의 표기 조건과 새 화자 평가가 학습 효과의 해석을 바꾸는 과정도 짚는다.
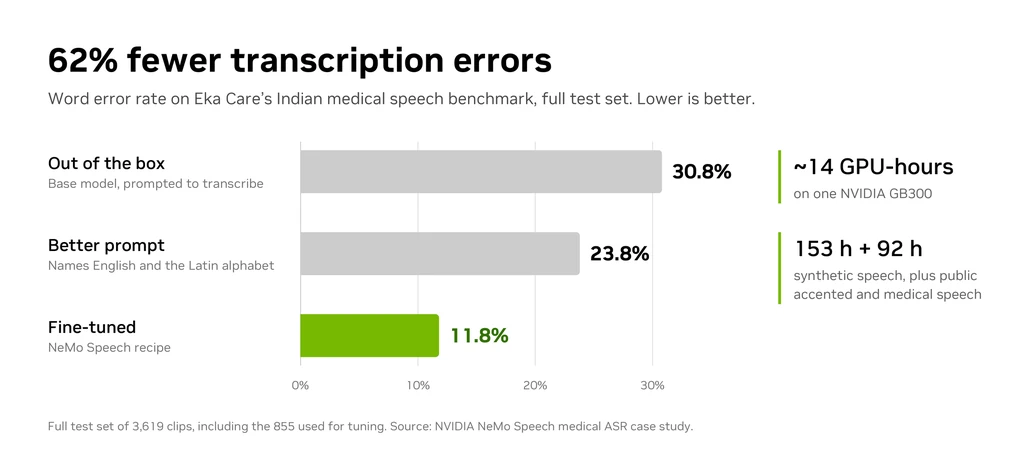
같은 파인튜닝 사례를 두고 음성 인식 오류를 62% 줄였다는 말과 45.8% 줄였다는 말이 함께 나온다. 어느 쪽이 틀린 숫자일까? 비교를 시작한 모델 설정과 평가에 사용한 음성이 다르면 둘 다 맞을 수 있다. 핵심은 더 큰 숫자를 고르는 것이 아니라, 학습으로 추가 해결한 오류를 분리해 내는 일이다.
NVIDIA Nemotron 3.5 Transcribe 사례를 바탕으로 WER의 단어 정렬부터 상대 감소율, 합성 학습 라벨, 화자 분리까지 차례로 살펴보자. 아래의 짧은 문장과 가상 오류 집계는 계산 방식을 설명하기 위한 예제다. 이 글에서 모델을 직접 학습하거나 의료 음성을 평가하지는 않았다.
WER은 문장을 정렬한 뒤 오류를 센다
WER 지표 문서 (새 창)의 계산식은 (치환 S + 삭제 D + 삽입 I) / 정답 단어 수 N이다. 출력의 몇 퍼센트가 틀렸는지 세는 식과는 다르다. 먼저 정답과 예측의 단어 순서를 정렬해 어떤 단어를 바꾸고, 빼고, 넣어야 두 문장이 일치하는지 구한다.
설명용 정답을 “please open the red box”, 예측을 “please open blue box now”라고 하자. 공백을 기준으로 정답 단어는 5개다. 한 최소 편집 정렬에서는 the를 삭제하고 red를 blue로 치환한 뒤 now를 삽입한다. 따라서 S=1, D=1, I=1이고 WER은 3/5, 즉 60%다. 개별 정렬 방식의 표현이 달라도 최소 편집 수는 같다.
이때 오류 수를 예측 단어 수로 나누거나 정답과 같은 위치의 단어만 비교하면 다른 지표가 된다. 삽입이 많으면 WER이 100%를 넘을 수도 있다. 따라서 단순히 100에서 WER을 뺀 값을 일반적인 정답률이라고 부르는 데는 주의가 필요하다. 어떤 오류가 실제 업무 결과를 바꿨는지도 이 숫자 하나만으로는 알 수 없다.
62%에서 분모는 기본 프롬프트의 오류다
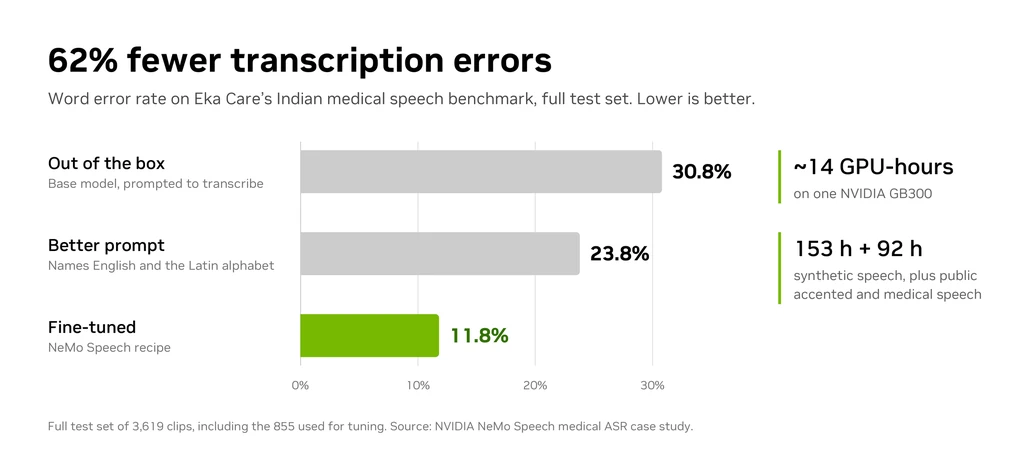
NVIDIA 발표 (새 창)의 그림은 전체 3,619개 음성에서 기본 프롬프트 WER 30.8%, 개선 프롬프트 23.8%, 파인튜닝 11.8%를 비교한다. 영어와 라틴 문자를 명시하는 것만으로 줄어든 오류는 가운데 단계에 반영되어 있다.
기본 설정부터 최종 모델까지의 상대 감소율은 (30.8−11.8)/30.8로 약 61.7%다. 반면 같은 전체 집합에서 개선 프롬프트를 기준으로 비교하면 (23.8−11.8)/23.8로 약 50.4%다. 프롬프트로 먼저 해결한 오류까지 학습 효과에 포함할지에 따라 분모와 해석이 달라진다. 두 감소율을 단순히 더하는 계산 역시 성립하지 않는다.
더 중요한 조건은 이 전체 집합에 설정 선택용 음성 855개가 포함되어 있다는 점이다. 아래 그림의 큰 개선율을 처음 보는 음성에 대한 독립 평가로 읽으면 안 된다. 숫자를 인용할 때는 시작 설정, 최종 설정, 평가 집합이라는 세 가지 기준이 함께 제시되어야 비교가 성립한다.
화자를 나누는 것은 무엇을 시험하기 위해서인가
고정 리비전 재현 문서 (새 창)는 설정 선택용 음성 855개와 미사용 화자 음성 2,764개를 구분한다. 미사용 집합에서는 최선 프롬프트의 WER 22.44%와 파인튜닝의 WER 12.17%를 동일한 KARMA 평가기로 비교했다. 두 결과의 차이는 10.27%포인트이며 상대 감소율은 10.27/22.44로 약 45.8%다. 앞서 살펴본 50.4%와는 평가 집합 자체가 다르다.
음성 클립만 무작위로 나누면 한 사람이 말한 서로 다른 문장이 양쪽 집합에 모두 들어갈 수 있다. 화자를 분리하는 것은 설정 선택 과정에 등장하지 않은 사람의 음성에서도 성능이 개선되는지 확인하기 위해서다. 그러나 새로운 화자라는 조건만으로 새로운 언어나 병원, 마이크 환경까지 대표할 수는 없다. 분리 기준 하나가 모든 종류의 일반화를 보장하지는 않는다.
평가 데이터의 용도도 구분해야 한다. 학습 가중치를 갱신하는 데이터, 프롬프트와 체크포인트를 고르는 데이터, 최종 후보를 비교하는 데이터는 각기 다른 의사결정에 쓰인다. 최종 평가 결과를 확인하며 후보 모델을 계속 고르면, 그 평가 집합도 모델 선택에 영향을 주기 시작한다. 따라서 단순히 train/test라는 이름을 붙이는 것보다 무엇을 언제 보고 결정했는지 기록하는 일이 더 중요하다.
같은 소리를 어떤 표기로 가르칠지도 학습 조건이다
이 사례는 음성을 생성하는 문자열과 정답으로 가르칠 문자열을 구분한다. 공식 재현 문서에서는 HbA1c라는 학습 라벨은 그대로 두되, 음성 합성기에는 H B A one C처럼 실제 발음할 형태를 전달한다. 합성기가 약어를 엉뚱하게 읽으면 정답 라벨이 맞아도 음성과 텍스트 학습 쌍의 연결이 어긋날 수 있기 때문이다.
그다음 하나의 음성에 표기 관례가 다른 학습 행들을 만들고, 프롬프트에 원하는 표기 관례를 명시한다. 예를 들어 같은 수량 표현을 500mg이나 500 mg로 쓸 수 있다고 가정하면, 음성만으로는 어느 띄어쓰기가 정답인지 결정하기 어렵다. 입력 프롬프트에 표기 조건을 주면 모델이 이러한 출력 규칙을 학습하는 단서가 된다. 물론 이는 실제 두 문자열의 KARMA 점수를 측정한 예시는 아니다.
평가 전처리 방식도 결과에 영향을 준다. 대소문자·구두점·숫자·단위를 어떻게 처리하느냐에 따라 같은 예측이라도 다른 점수가 나올 수 있다. 결과를 확인한 뒤에 정규화 규칙을 바꾸기보다는 비교 전에 미리 고정하고, 원문 출력과 정규화된 출력을 함께 남겨 두는 편이 결과를 해석하기 쉽다. 단위의 차이를 모두 지워 버리면 실제로 중요한 오류까지 가려질 수 있다.
평균 오류와 중요한 용어 오류를 함께 본다
가상 평가에서 일반 단어 오류가 100개에서 50개로 줄고, 중요한 이름 오류가 5개에서 8개로 늘었다고 해 보자. 정답 단어 수가 같다면 전체 오류는 105개에서 58개로 줄어들지만, 이름 구분이라는 업무 목표에서는 오히려 성능이 나빠진다. 모든 오류를 똑같이 한 개로 세는 지표와 실제 업무의 중요도가 다르기 때문이다.
공식 미사용 화자 평가에서도 전체 WER의 우세와 세부 항목별 우세를 구분한다. 브랜드 약품명의 정확 일치 항목에서는 오히려 전문 모델이 앞서는 경우가 있었다. 이 결과를 한국어 서비스에 적용하려면 한국어 환경의 실제 오류와 표기 조건으로 다시 검증해야 한다.
먼저 개발 데이터에서 프롬프트와 표기 규칙을 고정하고, 동일한 평가기로 기본 모델과 학습 후보 모델을 비교한다. 최종 판단을 내릴 때는 새로운 화자에 대한 전체 오류뿐만 아니라 핵심 용어와 일반 음성의 인식 변화를 함께 살펴본다. 학습으로 풀어야 할 문제는 단순히 “WER을 더 낮추기”에서 끝나지 않는다. 프롬프트만으로 해결되지 않고 남은 오류 중 무엇을 고칠지, 그리고 그 대가로 어떤 성능을 잃지 않아야 하는지까지 정해야 한다.