Hugging Face 캐시는 왜 삭제해도 그대로일까: 공유 파일과 참조 추적
모델 저장소를 삭제해도 공간이 그대로인 이유를 공유 파일과 참조로 설명한다. Hugging Face 코드와 8 GB 예제로 중복 다운로드·논리 용량·실제 회수를 구분한다.
모델 저장소 하나를 지웠는데도 디스크 공간이 예상만큼 돌아오지 않을 수 있다. 여러 저장소가 같은 파일 하나를 가리키고 있다면 다른 저장소가 쓰는 파일 실체는 남겨야 하기 때문이다. Hugging Face 공유 캐시는 이 관계를 파일 해시와 링크로 관리한다. 다운로드를 줄이는 구조가 삭제 방식까지 바꾸는 이유를 따라가 보자.
공유 blob 저장소는 huggingface_hub v1.32.0 릴리스 (새 창)에 포함됐다. 아래 설명은 v2.4.0 코드를 기준으로, 같은 캐시 디렉터리에서 심볼릭 링크와 Xet 경로를 사용하는 경우를 다룬다. 모델을 직접 내려받아 속도를 측정한 결과는 아니다.
저장소 경로 두 개, 파일 실체 한 개
가상의 모델 저장소 A와 B에 같은 8 GB 파일이 들어 있다고 하자. 파일명은 달라도 Xet 파일 해시가 같고, 두 저장소가 같은 캐시 디렉터리를 사용한다는 가정이다. 각 저장소에 따로 저장하면 파일 실체가 두 개라 16 GB가 필요하다. 이를 공유하면 큰 파일은 하나만 두고, 저장소별 경로는 그 파일을 가리키는 링크로 만든다. 여기서 용량 계산은 작은 메타데이터와 파일시스템 할당 단위를 제외한다.
다운로드 코드 (새 창)는 저장소별 blobs 경로를 없애지 않는다. snapshot의 파일명은 저장소의 blobs 항목을 가리키고, 그 항목이 다시 캐시 최상위 blobs에 있는 공유 파일을 가리킨다. 기존 모델 로더가 기대하는 경로를 유지하면서 파일 실체만 한곳에 모으는 방식이다.
shared_blob_path (새 창)는 Xet 해시 앞 두 글자를 하위 디렉터리로 삼는다. 따라서 A와 B처럼 저장소 이름이 달라도 해시가 같으면 목적지가 같다. 반대로 이름이 같아도 파일 내용이 달라 해시가 바뀌면 다른 실체를 쓴다. 모델 제품명이 같다는 이유만으로 공간이 줄지는 않는다.
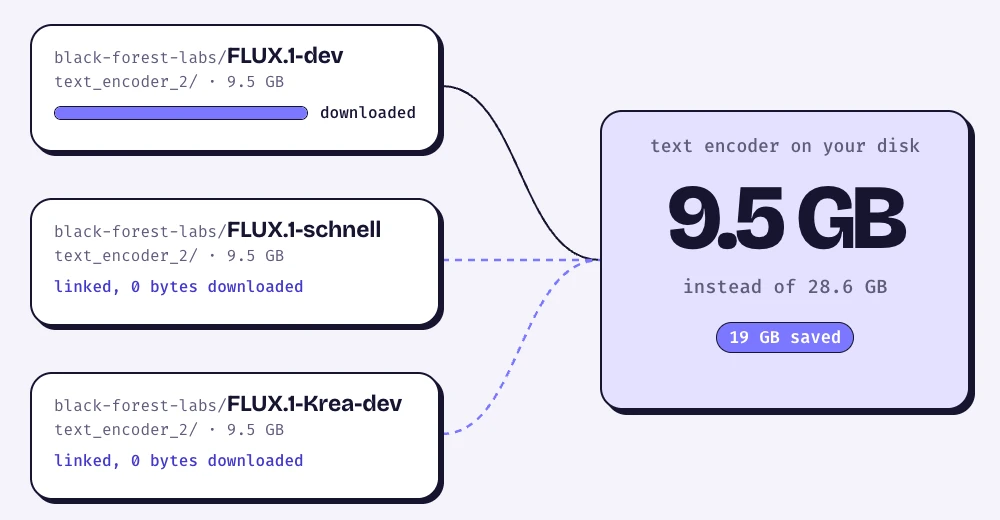
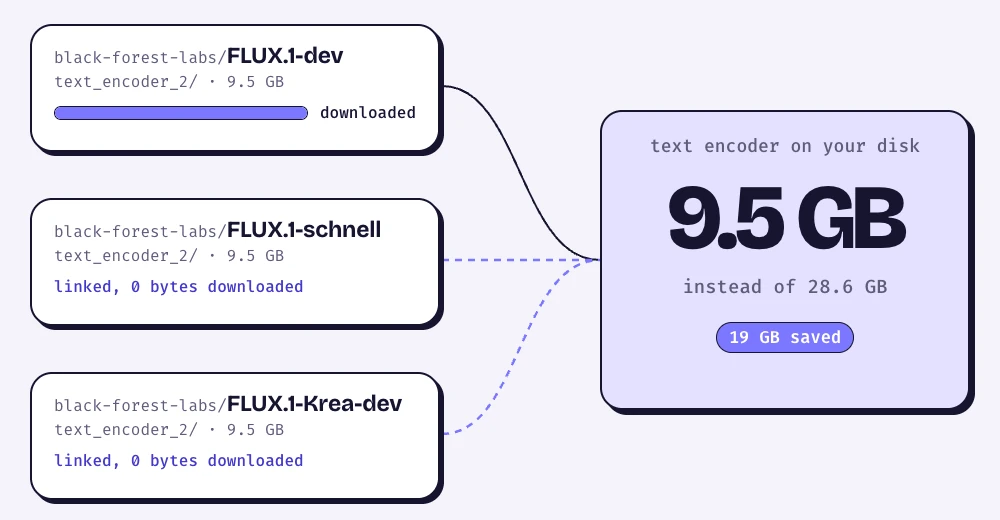
아래 공식 그림은 FLUX 세 저장소가 같은 텍스트 인코더를 공유하는 사례다. 그림에 반올림해 표시된 9.5 GB·28.6 GB는 제공자의 예시이며, 위에서 가정한 8 GB 계산이나 이 환경의 실측값과는 구분한다.
두 번째 다운로드에서 생략하는 작업
A를 처음 받을 때는 공유 저장소에 파일이 없으므로 내려받아야 한다. Xet 경로로 검증된 파일은 publish_blob_to_shared_store (새 창)를 거쳐 공유 위치로 옮겨지고, 원래 저장소의 blob은 링크로 바뀐다. 다운로드 코드는 일반 HTTP 대체 경로로 받은 파일을 이 공유 등록 경로에 넣지 않도록 구분한다.
이후 B를 받을 때는 try_link_from_shared_store (새 창)가 해시가 같은 파일을 찾는다. 일반 파일인지, 예상 크기와 맞는지, 읽을 수 있는지를 확인한 뒤 임시 링크를 만들고 참조 목록에 B를 기록한다. 마지막으로 임시 링크를 원래 경로로 교체한다. 공유 파일 잠금 안에서 참조 기록부터 남기는 순서다.
연결에 성공하면 큰 파일 전송은 건너뛴다. 다만 요청 전체가 네트워크 없이 끝난다는 뜻은 아니다. 저장소의 리비전과 파일 메타데이터를 확인하는 작업은 별도로 이루어진다. 또한 이 적중 검사에서 매번 파일 전체의 해시를 다시 계산하지는 않는다. 코드가 확인하는 크기·파일 유형·읽기 가능 여부를 전체 내용의 재검증과 혼동하지 않는다.
가상 예제에서 B를 추가할 때 큰 파일 전송량은 8 GB에서 0으로 줄고, 실제 저장 용량은 8 GB에 머문다. 만약 B가 수정된 파일을 써서 해시가 달라졌다면 새로운 8 GB 공간이 필요하다. 저장소 개수보다 실제로 겹치는 파일 내용이 절감량을 결정한다.
A를 지워도 8 GB가 남는 이유
공유 파일 옆에는 Xet 해시 뒤에 .refs가 붙은 참조 목록이 놓이며, 여기에 A와 B의 저장소별 blob 경로가 기록된다. 참조를 읽는 코드 (새 창)는 이 목록만 믿지 않고 실제 링크가 여전히 해당 실체를 가리키는지 확인한다. 오래된 경로를 단순히 세는 참조 카운터와는 다르다.
A를 삭제해도 B의 링크가 남아 있으면 sweep_shared_blob (새 창)는 파일을 지우지 않는다. 목록에 표시된 A의 크기가 8 GB였다고 해서 삭제할 때 8 GB가 그대로 반환되는 것은 아니다. 이후 B까지 제거해 유효한 참조가 모두 사라져야 공유 실체를 회수할 수 있다.
참조 목록이 없거나 읽을 수 없을 때도 파일을 지우지 않는다. 아무도 쓰지 않는다는 증거를 얻지 못했기 때문이다. 이는 공간을 일부 남기더라도 다른 저장소의 정상 파일이 깨질 가능성을 줄이는 선택이다. 따라서 공간이 회수되지 않았다고 해서 곧바로 중복 저장 오류로 단정할 수는 없다.
용량을 볼 때 합산할 값과 확인할 조건
공식 캐시 안내 (새 창)는 저장소별 논리 용량과 캐시 전체의 물리 용량을 구분한다. A와 B에 각각 8 GB가 표시되더라도 공유 실체는 8 GB 하나뿐이다. 저장소별 숫자를 단순 합산한 16 GB를 실제 디스크 사용량으로 읽으면 절감 효과를 놓치게 된다.
공유 캐시가 작동하려면 심볼릭 링크를 사용할 수 있어야 한다. HF_HUB_DISABLE_XET=1이나 HF_HUB_DISABLE_SHARED_BLOBS=1이 설정되면 이 경로는 꺼진다. 권한이나 파일시스템 문제로 공유에 실패하면 저장소별 저장 방식으로 돌아갈 수 있으므로, 다운로드에 성공했다고 해서 공유까지 성공한 것은 아니다. 서로 다른 캐시 루트를 쓰는 환경에서도 이 공유 저장소를 함께 쓰지 못한다.
같은 파일을 여러 모델에서 쓰는 개발 환경이라면 공유 구조의 이점이 크다. 반면 파일이 매번 다르거나 작업마다 캐시를 비운다면 재사용할 실체가 없다. 캐시를 정리할 때는 현재 버전의 hf cache 도구로 참조 관계를 다루고, 삭제 예정 용량과 캐시 전체 사용량을 함께 확인할 수 있다. 이 글의 가상 예제에서는 A를 삭제한 뒤에도 B가 읽는 8 GB가 남는 것이 정상이며, 그 남은 참조가 공간 회수 여부를 결정한다.