검색 77회를 줄이면 정말 저렴해질까: RAG의 첫 STOP과 판정 비용
처음 선택한 STOP이 뒤의 올바른 판단을 무효화하는 과정을 추적한다. 검색 절약분과 판정 모델 비용을 같은 단위로 계산해 도입 조건을 설명한다.
2026.08.13 공개된 Search-R1 연구는 설정을 고정한 Search-R1과 비교해 검색 호출을 77회 줄이는 동안 Official Exact Match가 0.625%p 낮아졌다고 보고한다. 다만 중단 여부를 판단하는 모델의 실행 비용까지 합산한 개선 폭은 측정하지 않았다.
뒤의 올바른 판단은 첫 오판을 복구하지 못한다
현재 근거가 충분한지, 부족한 정보는 무엇인지 구조화해 예측하더라도 상태별 분류 정확도만으로 배포 여부를 판단할 수는 없다. 질문마다 처음 멈춘 시점의 답과 검색량을 측정해야 한다.
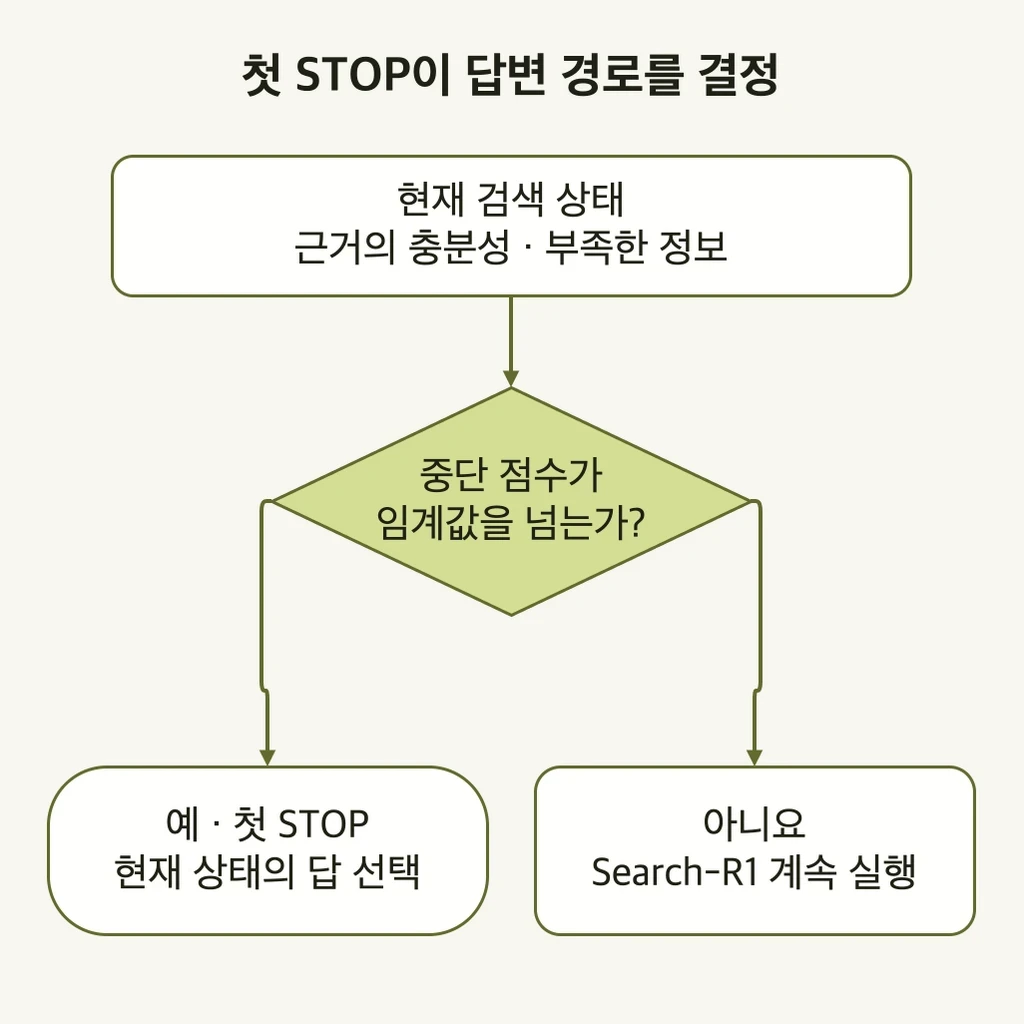
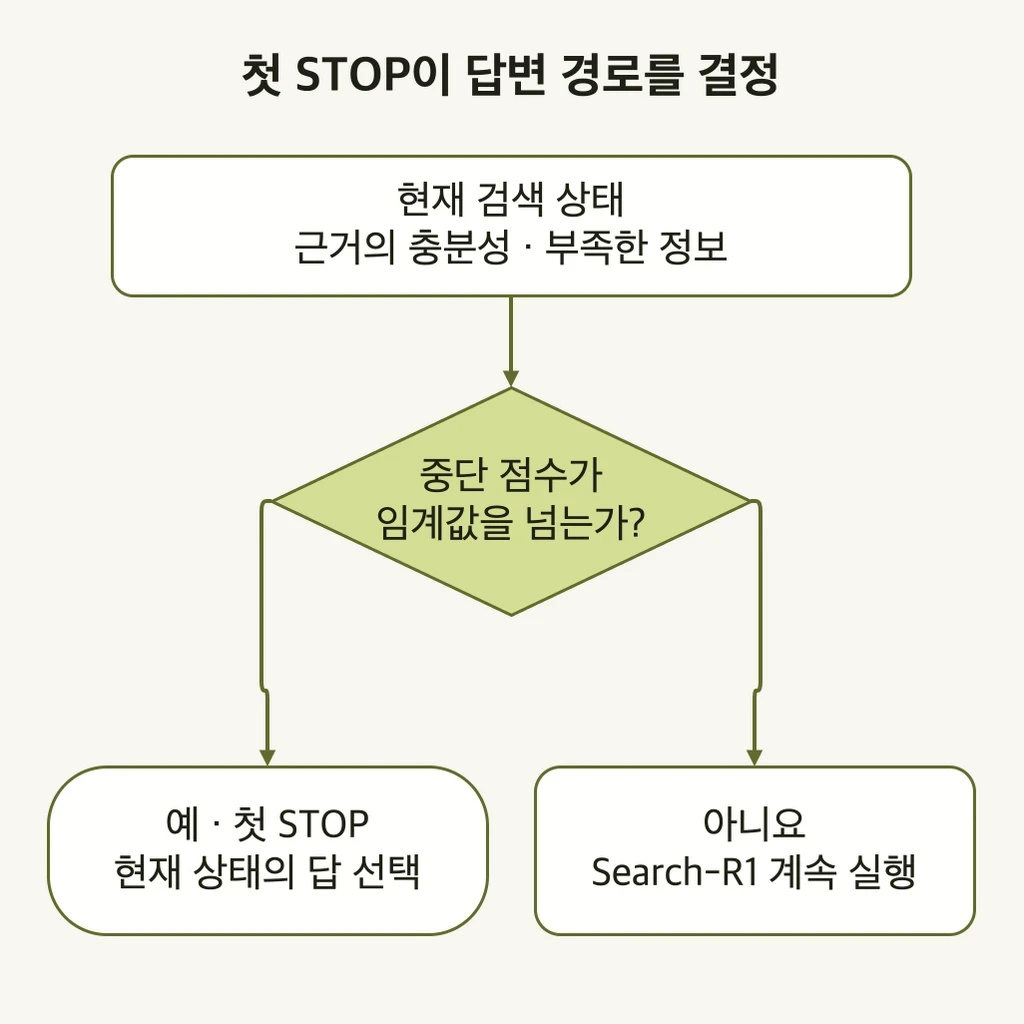
개별 상태에서 STOP을 잘 맞히는 judge라도 배포 정책으로는 실패할 수 있다. 두 번째 검색 뒤에 안전하게 멈출 수 있더라도 첫 번째 검색 뒤에 잘못 멈춰버리면 그 뒤의 올바른 판단은 실행조차 되지 않기 때문이다. 따라서 점수가 처음 임계값을 넘는 시점이 중요하다.
Search-R1을 고정한 800개 질문 평가
Weimeng Luo는 Search-R1의 reasoner, retriever, corpus, prompt와 검색 예산을 고정했다. 900개 HotpotQA 질문에서 얻은 3,009개 상태로 별도의 Qwen3.5-2B judge를 학습시켰고, grouped validation에서 checkpoint와 threshold를 고른 뒤 confirmatory test 전에 고정했다.
최종 평가는 800개 질문으로 수행했다. 공개 저장소에는 first-stop 평가 코드와 집계 결과, 실험 protocol이 있지만 질문별 trajectory·label·모델 weight·LoRA adapter는 빠져 있다. 2026년 9월 22일에 확인한 저장소 공개본에는 소프트웨어 라이선스가 부여되지 않아 코드를 자유롭게 재사용할 수 없다.
첫 STOP이 전체 정책을 결정한다
판단 모델(judge)은 각 검색 상태에서 충분한 근거와 부족한 정보를 점수화한다. 점수가 임계값을 처음 넘으면 검색을 끝내고 그 상태의 답을 선택하며, 끝까지 넘지 못하면 Search-R1의 원래 동작을 따른다.
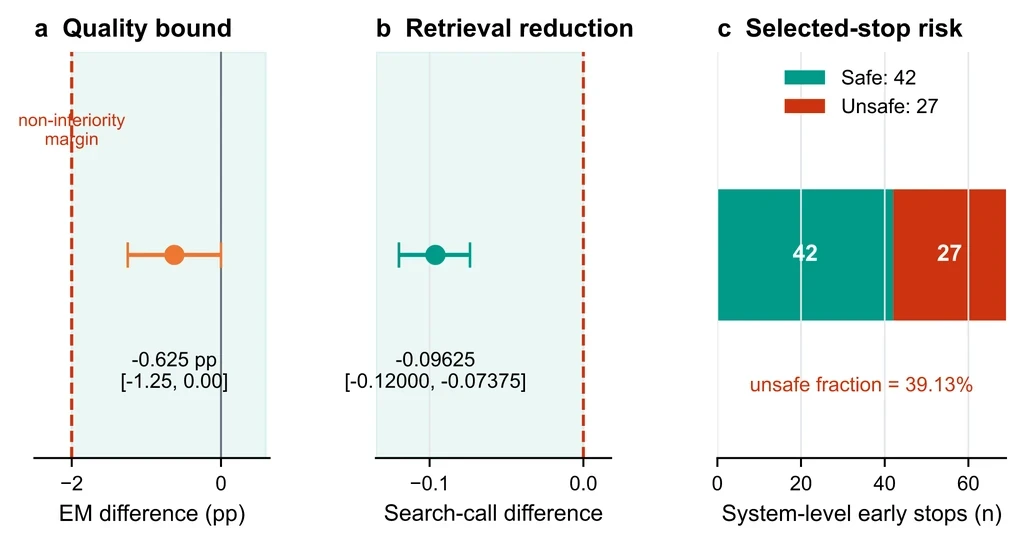
threshold는 STOP precision이 0.90 이상인 후보 중 validation 목표를 만족하는 값으로 골랐다. 하지만 최종 test에서는 이 제약이 유지되지 않았다. 69회의 early stop 가운데 27회가 연구 기준상 unsafe로 나타났다. 전체 질문의 평균 EM 손실 한도는 통과했지만 개별 STOP의 안전성까지 보증하지는 못한다.
수치에서 읽어야 할 것
Native Search-R1의 Official EM은 0.44875, 평균 검색 호출은 2.60125였다. Expanded S2G LoRA 정책은 EM 0.44250, 평균 호출 2.50500을 기록해 800개 질문 전체에서 검색 호출이 2,081회에서 2,004회로 줄었다.
EM 차이는 -0.00625이며 95% 신뢰구간은 [-0.01250, 0]이다. 사전 정의한 -0.02 non-inferiority 경계 안에는 들었지만, 이것이 동등성이나 우월성을 뜻하지는 않는다. 검색 호출 차이의 95% 신뢰구간은 질문당 [-0.12000, -0.07375]로 0을 포함하지 않았다.
Qwen3.5-2B judge는 판단 대상 상태마다 실행된다. 연구는 이 연산량·메모리·지연을 검색 호출과 같은 비용 단위로 환산하지 않았다. 검색이 비싸거나 judge를 배치 처리해 비용을 나눌 수 있는 환경에서 3.70% 감소가 실제 이익으로 이어지는지 따져야 한다.
RAG 평가에 적용할 기준
중단 judge를 만들기 전에 실제 trajectory 안에 제거 가능한 검색 호출이 있는지 oracle headroom부터 확인해야 한다. headroom이 거의 없다면 복잡한 judge는 비용만 더할 뿐이다. 이어 state-level AP와 STOP precision을 확인하되 이를 배포 성능으로 삼지는 않는다.
최종 gate는 first-stop policy replay다. 질문별 첫 STOP과 그때 답의 정오, safe·unsafe stop, 검색 호출, 생성 token, judge latency, 총비용을 함께 기록해야 한다. 평균 정확도 허용 폭과 개별 위험 허용 폭도 분리해야 한다. 의료·법률처럼 잘못된 조기 종료의 비용이 큰 서비스는 평균 EM non-inferiority만으로 배포하기 어렵다.
가상의 한 질문에서 첫 검색 뒤 점수가 0.92지만 답은 틀리고, 두 번째 검색 뒤 점수가 0.95이며 답은 맞다고 가정해 보자. 임계값이 0.90이면 첫 상태에서 멈춰 오답을 낸다. 두 상태를 독립된 분류 자료로 평가해 두 번째 판단이 좋다고 칭찬하더라도 실제 배포 환경에서는 그 상태에 도달하지 못한다. 정책 재생은 ‘처음 멈춘 위치’에서 이후 경로를 잘라내야 한다. 이 점수는 논문의 관측값이 아닌 설명용 예시다.
비용도 질문 단위로 합산한다. 보고된 77회 절약을 비용 단위로 환산할 때, 가정상 검색 한 번이 10단위이고 전체 평가에서 judge를 2,000번 실행해 매번 1단위를 썼다면 절약은 770단위, 추가 비용은 2,000단위가 되어 총비용은 오히려 1,230단위 늘어난다. 같은 호출 수에서 judge 실행 한 번이 0.2단위라면 400단위를 써 순절약은 370단위가 된다. 이는 실제 연구의 judge 실행 수나 단가를 뜻하지 않는다.
일반적으로 절약한 검색 수에 검색 단가를 곱한 값이 judge 총비용과 추가 생성·운영 비용을 넘어야 비용 이득이 발생한다. 병렬 배치로 단가를 낮추더라도 사용자 대기 시간은 따로 측정한다. 검색량, 총요금, 지연과 unsafe STOP을 각각 기록해야 무엇을 절약하고 어떤 위험을 감수했는지 설명할 수 있다.
검색 절약과 중단 위험은 별도 기준이다
이 연구는 HotpotQA와 설정을 고정한 Search-R1 단일 구성을 다룬다. 77회 감소는 통계적으로 유의미하지만 절대 규모는 작고 27개의 unsafe early stop이 남았다. 모델·retriever·검색 단가가 바뀌면 최적 threshold와 비용 균형도 달라진다.
도입을 비교할 때는 질문별 첫 STOP을 재현하고 답의 정오, 잘못된 중단, judge를 포함한 전체 비용을 함께 기록한다. 3.70%의 검색 절약을 수용할지는 평균 정확도와 개별 중단 위험을 각각 검토해 결정해야 한다.
참고 자료
When Should Multi-Round RAG Stop? Structured Stopping Judgments and Retrieval Reduction in Search-R1
Search-R1 × S2G Stopping official repository