UMT5는 왜 미래 토큰을 봤을까: 실행 성공 뒤에 숨은 causal mask 오류
UMT5가 미래 토큰을 읽던 오류를 공식 수정 코드로 살펴본다. 마지막 토큰만 바꾸는 회귀 테스트와 허용 오차의 함정, 작은 모델에서도 SDPA 실행 경로를 유지해야 하는 이유를 설명한다.
모델 호출이 정상적으로 끝나고 출력 텐서의 크기가 맞더라도, 디코더가 아직 보면 안 되는 토큰을 읽는 문제가 생길 수 있다. UMT5에서 실제로 수정된 causal mask 오류가 바로 그런 사례다. 단순히 예외 발생 여부만 확인해서는 이런 문제를 놓치기 쉽다. 마지막 입력 토큰만 바꿨을 때 앞쪽 출력이 그대로 유지되는지 비교하면, 실행 성공 여부와 별개로 시간 방향의 제약을 지키는지도 검사할 수 있다.
Hugging Face의 Model Integration Contracts 소개 (새 창)는 작은 모델을 활용해 이런 회귀 오류를 빠르게 잡아내는 접근법을 다룬다. 이 글에서는 그중 UMT5 수정 코드와 회귀 테스트를 살펴보며, 무엇을 바꾸어 무엇과 비교하는지 따라가 본다. 모델을 직접 실행한 재현 실험은 아니다.
위치 정보만 더한다고 미래가 가려지지는 않는다
디코더의 자기 어텐션에서는 현재 위치가 앞선 토큰과 자기 자신만 볼 수 있고, 뒤쪽 토큰은 볼 수 없어야 한다. 예를 들어 디코더 입력이 [시작, A, B, C]라면 A 위치에서는 B와 C를 읽으면 안 된다. 이 배열은 원리를 설명하기 위한 예시이며 실제 테스트의 토큰 문자열은 아니다.
UMT5 수정 커밋 (새 창)은 자기 어텐션에 is_causal=config.is_decoder를 전달한다. 반면 인코더 출력을 읽는 교차 어텐션에는 is_causal=False를 명시한다. 같은 디코더 안에서도 두 어텐션이 읽는 대상이 다르므로, 모든 어텐션을 일괄적으로 causal로 만든다고 해결되는 문제는 아니다.
SDPA 구현의 create_position_bias_mask (새 창)는 별도의 attention_mask가 없을 때 is_causal 값을 확인한다. 이 값이 참이면 질의 위치가 키 위치보다 뒤이거나 같은 칸만 허용하고, 나머지는 dtype의 최솟값으로 채운다. 이 최솟값은 어텐션 점수에 더해져 softmax 계산 시 미래 위치의 기여를 억제한다. 거짓이면 position_bias만 사용한다. 위치에 따라 가중치를 주는 것과 미래 위치를 금지하는 것은 서로 다른 역할이다.
위 예시에서 A가 있는 위치에는 자기 자신까지만 허용하는 행이 필요하다. 위치 편향만 남은 행에서는 B나 C가 단지 다른 점수를 받을 뿐, 참조 자체가 금지되지는 않을 수 있다. 텐서의 크기나 반환 형식에 문제가 없어도 결과의 의미가 틀릴 수 있는 이유가 여기에 있다. 이 설명은 해당 수정 시점의 SDPA 경로를 읽고 정리한 것이며, 모든 백엔드의 마스크 구현으로 일반화한 것은 아니다.
C를 D로 바꿔도 A와 B의 출력은 같아야 한다
공식 test_decoder_causal_mask (새 창)는 인코더 입력을 고정한 채 디코더 입력을 복제한다. 그리고 복제본의 마지막 토큰 ID만 바꾼 뒤 각각 실행해 last_hidden_state를 비교한다. 이때 마지막 위치 자체는 비교 대상에서 제외한다. 바꾼 토큰 위치의 출력은 달라져도 되지만, 그보다 앞선 위치의 출력이 미래의 변경에 영향받아서는 안 되기 때문이다.
설명용 배열로 나타내면 [시작, A, B, C]와 [시작, A, B, D]에서 앞의 세 위치를 비교하는 셈이다. A와 B는 앞선 문맥이 같으므로, 미래를 제대로 가린 자기 어텐션이라면 C와 D의 차이를 알 수 없다. 만약 앞쪽 결과가 달라졌다면 마지막 토큰의 정보가 거꾸로 전달된 경로가 있다고 의심할 수 있다. 반대로 출력 전체가 같아야 한다고 검사하면, 정상적으로 달라질 수 있는 마지막 위치의 변화까지 오류로 판정하게 된다.
여기에는 테스트 자체의 함정도 있다. 코드 주석에 따르면 공통 테스트 설정인 initializer_factor=0.002에서는 인과성 위반으로 인한 차이가 약 8e-09에 그쳐 허용 오차 아래로 묻혔다. 수정된 테스트는 이를 initializer_factor=1.0으로 바꾸고 torch.allclose에 atol=1e-4를 전달한다. 비교 코드를 넣더라도 입력과 가중치가 오류를 충분히 드러내지 못하면 테스트가 그대로 통과할 수 있다는 뜻이다. 이 값들은 공식 테스트의 조건일 뿐, 다른 모델에 그대로 적용할 권장 설정은 아니다.
따라서 테스트를 추가한 뒤에는 정상 구현이 통과하는지만 볼 것이 아니라, 문제의 수정을 되돌렸을 때 테스트가 실제로 실패하는지도 확인할 필요가 있다. 두 결과의 차이가 작다는 사실만으로는 마스크가 올바르게 작동하는지, 아니면 테스트가 변화에 둔감한 것인지 구별할 수 없다.
작은 모델에도 문제를 일으킨 실행 경로를 남긴다
MIC fixture 문서 (새 창)는 모델 크기를 줄이더라도 레이어 종류와 사용 경로는 그대로 유지하고, 토크나이저·프로세서와 가중치를 고정하는 방식을 설명한다. 이는 큰 모델의 답변 품질을 작은 모델로 예측하려는 목적이 아니다. 라이브러리를 수정했을 때 동일한 입력과 경로에서 동작이 달라지는지 빠르게 비교하려는 장치다.
공개 검증 기록 (새 창)에서는 UMT5의 수정 사항을 되돌린 경우를 작은 fixture로 검사했다. 그 결과 eager 경로만 봤을 때는 놓쳤던 변화를 SDPA 경로에서 포착했다. 같은 이름의 모델을 실행했다고 해서 같은 구현 경로를 검사했다고 볼 수는 없다. 실제로 사용하는 경로가 SDPA라면, eager에서 통과했다는 결과만으로 그 변경 사항을 안심하기는 어렵다.
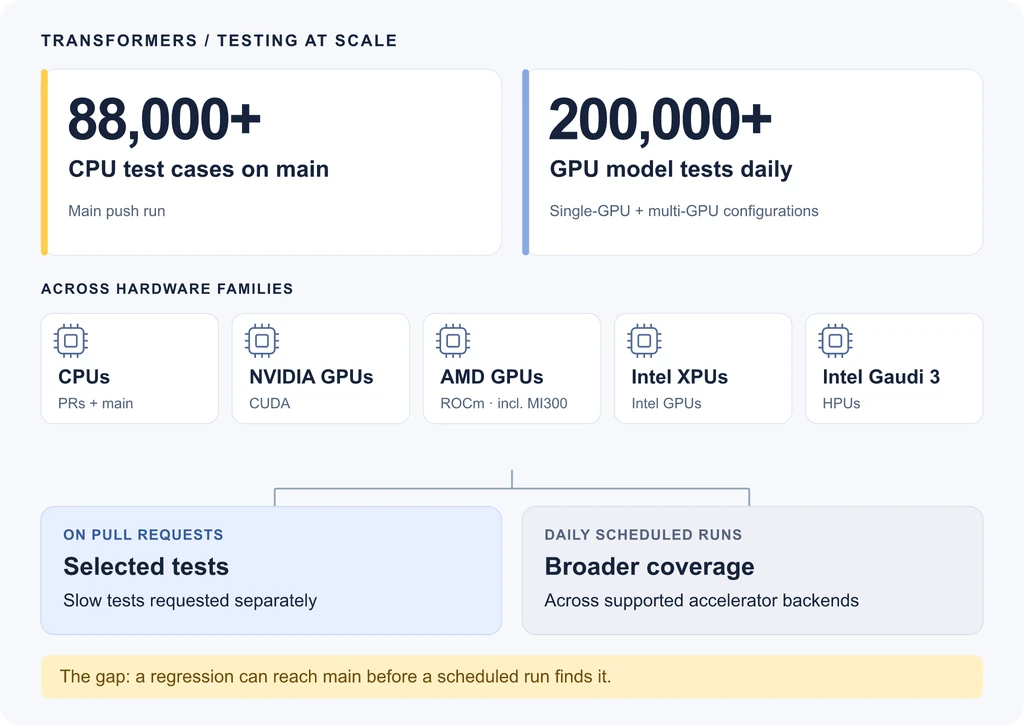
아래 공식 그림은 테스트 수가 많더라도 실행 시점과 범위가 다르다는 점을 보여 준다. 위쪽의 CPU·GPU 수치는 전체 테스트 규모를 나타내고, 아래쪽은 PR 단계에서 선택적으로 돌리는 검사와 정기 실행에서 돌리는 더 넓은 검사를 구분해 보여 준다. 매일 실행하는 넓은 검사에서 잡히는 오류라도 병합 전에 실행하지 않았다면 그 빈틈으로 유입될 수 있다. 작은 계약 테스트의 가치는 단순히 테스트 수를 늘리는 데 있는 것이 아니라, 필요한 경로를 PR 단계에서 실행하는 비용을 낮추는 데 있다.
통과 결과에는 입력·백엔드·검사 항목을 함께 남긴다
내가 라이브러리 변경을 검토한다면 먼저 이 UMT5 사례처럼 “마지막 토큰을 바꿔도 앞쪽 상태는 유지된다”는 조건을 하나 고를 것이다. 그런 다음 실제로 사용하는 백엔드에서 정상 구현과 오류를 주입한 구현을 비교한다. 이 조건은 인과성 위반을 겨냥한 것이다. 생성 품질이나 긴 시퀀스, 캐시를 사용하는 후속 토큰 처리까지 한 번에 보장하는 검사는 아니다.
작은 fixture의 수치 기준 역시 어떤 환경에서나 똑같은 값으로 고정할 수 있는 것은 아니다. fixture 문서 (새 창)는 가중치 파일은 공유하되 기준 출력은 플랫폼과 dtype에 따라 구분한다고 설명한다. 가중치가 바뀐 것인지, 실행 환경이 바뀐 것인지, 아니면 라이브러리가 바뀐 것인지를 분리해야 비교 결과를 정확히 해석할 수 있다.
MIC는 아직 기존의 모든 통합 테스트를 대체하는 장치가 아니다. 현재 검증 기록 (새 창)의 CI 연결 역시 결과를 보고만 하는 비차단 단계다. 이를 이미 병합을 막아 주는 완성된 안전장치로 소개한다면 실제 범위를 넘어서는 셈이다.
이 사례에서 남길 만한 회귀 테스트는 단순히 출력이 나왔음을 확인하는 것보다 구체적이다. 인코더 입력은 고정하고, 디코더의 마지막 토큰만 바꾼 뒤, 앞쪽 상태를 같은 백엔드에서 비교한다. 그리고 알려진 오류를 넣었을 때 그 비교가 실제로 실패하는지 확인한다. 작은 모델을 쓰더라도 이 관계를 보존해야, 빠른 통과가 과연 무엇을 확인한 결과인지 설명할 수 있다.