GraphRAG 요약에서 소수 의견이 사라지는 이유: 커뮤니티와 근거 확인
전역 요약의 대표성과 사실 정확도를 나누고, 커뮤니티 요약에서 빠진 근거를 최종 답변이 되살릴 수 없는 경우를 설명한다.
전역 질문에 커뮤니티 요약으로 답하기
관련 청크 몇 개로 답하기 어려운 질문
Vector RAG는 질문과 의미가 가까운 청크를 찾는다. 그러나 "이 코퍼스의 주요 테마는 무엇인가?" 같은 전역 질문(Global Sensemaking Query)은 문서 전반의 내용을 모아 요약해야 하므로 청크 몇 개만으로는 답하기 어렵다.
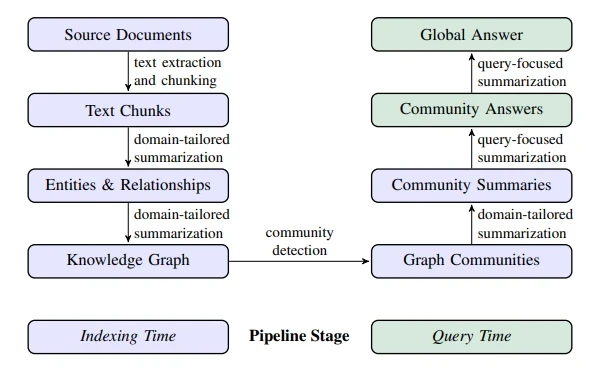
GraphRAG는 지식 그래프와 계층적 커뮤니티 구조를 만들고, 이를 Map-Reduce 방식으로 요약해 전역 질문에 답한다.
파이프라인 구조 (인덱싱 → 쿼리)
추출·커뮤니티 탐지·요약 설계
① 청크 분할 & Self-Reflection: 청크가 클수록 LLM 호출 비용은 줄지만 엔티티 추출 재현율(recall)이 급격히 떨어진다. 이를 보완하기 위해 추출 후 LLM에 누락된 엔티티가 있는지 다시 묻는다(Self-Reflection). 이때 logit bias=100으로 yes/no 응답을 강제해 yes일 때만 추가로 추출한다. 600 토큰은 논문에서 사용한 인덱싱 설정이며, 실제 self-reflection 횟수는 비용과 추출 품질을 비교해 정해야 한다.
② Leiden 커뮤니티 탐지: Leiden은 Louvain과 달리 분리된 노드 없이 잘 연결된(well-connected) 커뮤니티를 보장한다. 이를 계층적으로 재귀 적용해 C0(루트) → C1 → C2 → C3(리프)의 4단계를 생성하며, 각 레벨은 그래프의 모든 노드를 중복이나 누락 없이(MECE) 포괄한다.
③ Community Summary 생성 전략: 리프 레벨은 엣지 degree를 기준으로 우선순위를 매겨 토큰 한계까지 노드·엣지·클레임을 담는다. 상위 레벨은 개별 엘리먼트 요약 대신 하위 커뮤니티 요약을 넣어 토큰을 압축한다. 그 결과 C0는 전체 텍스트 요약(TS) 대비 토큰을 97% 줄이면서도 성능을 유지한다.
④ 평가 방법론 (LLM-as-a-Judge): 정답이 없는 전역 질문을 평가하기 위해 페르소나 기반 질문을 자동 생성하고, 일대일(헤드투헤드) 비교 승률을 측정한다. 평가 기준은 Comprehensiveness, Diversity, Empowerment, Directness 4가지다. 이 중 Directness는 역방향 검증을 위한 대조 지표로, SS(Vector RAG)가 우세하게 나오는 것이 정상이다.
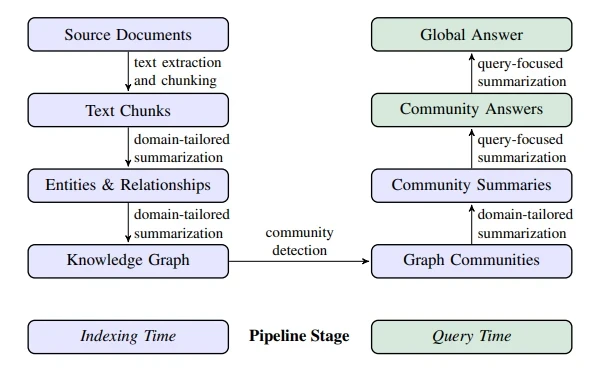
[인덱싱 타임]
Source Docs
  → Text Chunks (600 token, 100 overlap)
  → Entities & Relationships (LLM 추출)
  → Knowledge Graph (노드=엔티티, 엣지=관계)
  → Graph Communities (Leiden 알고리즘)
  → Community Summaries (계층적 LLM 요약)

[쿼리 타임]
Query
  → Map: 각 Community Summary → 부분 답변 + 유용도 점수(0-100)
  → Filter: 점수 0 제거
→ Reduce: 점수 내림차순 정렬 → 8k 컨텍스트 윈도우 채우기 → 최종 답변| 기준 | GraphRAG vs Vector RAG | 해석 |
|---|---|---|
| Comprehensiveness | 72~83% 승률 | GraphRAG 우위 |
| Diversity | 62~82% 승률 | GraphRAG 우위 |
| Empowerment | 혼재 | 구체적 인용구 부족이 원인 |
| Directness | SS 우위 | 설계대로 (간결성 vs 포괄성 트레이드오프) |
파이프라인 단계별 구현
단계별 구현 핵심 로직
[단계 1] 엔티티/관계 추출
[단계 2] 그래프 구축 & 커뮤니티 탐지
[단계 3] 커뮤니티 요약 생성
[단계 4] 쿼리 처리 (Map-Reduce)
인프라 구성 고려사항
입력: 텍스트 청크
처리:
  1. LLM 프롬프트 → (엔티티명, 타입, 설명) 리스트 추출
  2. Self-reflection 루프:
     - "더 추출할 엔티티 있나?" → YES/NO (logit bias로 강제)
     - YES면 continuation 프롬프트로 추가 추출
     - max_gleaning 횟수 도달 시 종료
  3. (소스, 타겟, 관계설명, 강도) 리스트 추출
출력: 엔티티 목록, 관계 목록

주의사항:
  - 동일 엔티티 중복 처리: exact string matching (기본) 또는 임베딩 유사도
- 엣지 중복 → 가중치로 집계 (출현 빈도는 반복 정도이지 사실의 신뢰도 보증이 아님)입력: 전체 엔티티/관계 목록
처리:
1. 엔티티 → 노드 (중복 통합, 설명 집계)
2. 관계 → 엣지 (가중치 = 중복 수)
3. Leiden 알고리즘 적용:
- resolution parameter로 커뮤니티 크기 조정
- 재귀적으로 각 커뮤니티 내부를 다시 Leiden 적용
- leaf 조건: 더 이상 분할 불가 (노드 수 임계값)
출력: 계층 트리 구조의 커뮤니티 할당입력: 커뮤니티별 노드/엣지/클레임 목록
처리 (Bottom-Up):
리프 레벨:
- 엣지 degree 내림차순 정렬
- (소스노드, 타겟노드, 엣지, 클레임) 순으로 컨텍스트 채우기
- 8k 토큰 한계까지 추가 후 LLM 요약
상위 레벨:
- 하위 요약 토큰 수 기준 내림차순 정렬
- 컨텍스트 오버플로우 시 엘리먼트 → 서브커뮤니티 요약으로 대체
- LLM 요약 (JSON 형식: title, summary, rating, findings)
출력: 각 커뮤니티별 구조화된 요약 JSON입력: 사용자 질문, 선택된 커뮤니티 레벨 (C0~C3)
처리:
MAP 단계 (병렬):
- 커뮤니티 요약들을 셔플 후 8k 청크로 분할
- 각 청크에 대해 LLM → (부분답변, helpfulness 점수 0-100)
- 점수 0 필터링
REDUCE 단계:
- 부분답변을 helpfulness 점수 내림차순 정렬
- 8k 컨텍스트에 순서대로 채우기
- 최종 LLM 합성 → 글로벌 답변
출력: 최종 답변 (마크다운 형식)저장소 선택:
- 그래프 DB: Neo4j (프로덕션) / NetworkX (프로토타입)
- 벡터 DB: 로컬 검색용 (하이브리드 방식 시)
- 요약 캐시: Redis (쿼리 타임 커뮤니티 요약 재사용)
LLM 호출 최적화:
- 엔티티 추출: 병렬 청크 처리 (rate limit 주의)
- 커뮤니티 요약: 리프부터 bottom-up, 병렬 가능
- MAP 단계: 완전 병렬 처리 가능 (핵심 성능 포인트)
비용 추정 (논문 기준):
- Podcast 약 1M 토큰, GPT-4-turbo·600-token 창에서 인덱싱 281분
(16GB RAM VM, Xeon Platinum 8171M, API 2M TPM·10k RPM 조건)
- C0 쿼리: TS 대비 97% 이상 컨텍스트 토큰 절감 보고
토큰 감소가 응답 지연이나 대화형 UX를 직접 보장하지는 않음한계와 추가 설계 후보
추가 설계안
① 하이브리드 검색 전략
② Just-in-Time 커뮤니티 요약
③ 엔티티 해소 (Entity Resolution) 강화
④ 멀티레벨 앙상블
⑤ 증분 인덱싱 (Incremental Indexing)
자동 평가와 인간 검토 병행
인덱싱 비용과 도입 판단
커뮤니티 요약은 전역 질문이 반복해서 들어오고 인덱싱 비용을 감수할 수 있을 때 도입한다. 특정 사실을 찾는 지역 질문까지 같은 경로로 처리할 필요는 없다. C0의 토큰 절감 수치만 보고 실시간 서비스 도입을 결정하지 말고, 실제 질문에 대한 답변 품질·인덱싱 갱신 비용·응답 지연을 함께 측정해 판단한다.
가상의 회의록 100개 중 90개가 출시 일정을 다루고, 10개가 소수 고객의 접근성 문제를 다룬다고 하자. 전체 주요 논의를 묻는 질문에서는 빈도가 하나의 단서가 되지만, “출시를 막을 위험은 무엇인가”라는 질문에서는 수가 적은 접근성 문서가 더 중요할 수 있다. 커뮤니티 크기나 등장 횟수를 모든 질문에서 곧바로 중요도로 삼으면 두 질문을 구분하지 못한다. 이 예시는 논문 평가셋의 결과가 아니다.
중간 요약 단계에서 접근성 관련 근거가 빠졌다면, 최종 Reduce 단계에서 그 요약만 읽고 원문의 사실을 복구할 수는 없다. 따라서 최종 답변의 문장만 검토하지 말고 원문 → 커뮤니티 요약 → 부분 답변 → 최종 답변으로 이어지는 과정에서 정보가 사라진 지점을 찾는다. 누락을 줄이려고 요약을 길게 늘리는 선택 역시 토큰 및 비용 증가와 함께 비교해야 한다.
평가 질문에는 자주 반복되는 테마와 드물지만 중요한 반례를 함께 넣고, 요약에 담긴 주장마다 원문 근거를 확인한다. LLM 심판이 더 포괄적이라고 고른 답변이라도 잘못된 사실을 많이 포함할 수 있으므로, 선호 승률과 사실 검증은 별도로 기록한다. 전역 요약이 유용한지와 원문의 모든 사실이 보존되었는지는 같은 합격 조건이 아니다.
| 한계 | 원인 분석 | 개선 포인트 |
|---|---|---|
| Empowerment 혼재 | 구체적 인용/예시가 그래프 압축 과정에서 손실 | 클레임 추출 프롬프트 고도화, 원문 청크 레퍼런스 유지 |
| 2개 데이터셋만 검증 | 도메인 일반화 미검증 | 의료/법률/코드 등 전문 도메인 실험 필요 |
| Hallucination 미측정 | SelfCheckGPT 등 미적용 | Fabrication rate 비교 실험 추가 |
| Exact string matching | 동일 엔티티 다양한 표현 미처리 | 임베딩 기반 엔티티 해소(Entity Resolution) 적용 |
현재: Global(커뮤니티 요약) vs Local(Vector RAG) 이분법

개선안: 질문 유형 자동 분류 → 라우팅
  - 전역 질문 → GraphRAG (레벨은 코퍼스·평가 기준별로 선택)
  - 로컬 질문 → Vector RAG
  - 혼합 질문 → 커뮤니티 요약 + 관련 청크 동시 활용
(논문의 "hybrid RAG schemes" 제안과 일치)현재: 모든 커뮤니티 요약을 인덱싱 타임에 사전 생성 (고정 비용)
개선안:
- 쿼리와 관련 높은 커뮤니티만 실시간 요약 생성
- "Roll-up" 방식: 하위 → 상위 방향으로 필요한 만큼만 집계
- "Drill-down" 방식: 상위 요약의 정보 단서 따라 하위 탐색
→ 사전 생성 범위를 줄이고 쿼리에 맞춰 요약 범위를 조정현재: exact string matching → "Apple Inc.", "Apple", "애플" 별도 노드
개선안:
1. 임베딩 클러스터링으로 후보 동일 엔티티 그룹 생성
2. LLM에게 "이 엔티티들이 동일한가?" 확인
3. 확인된 것만 병합 → False Positive 방지
→ 그래프 품질 향상 → 커뮤니티 구조 개선현재: 단일 커뮤니티 레벨 선택 (C0~C3 중 하나)
개선안: 여러 레벨 동시 활용
- C0 (전역 맥락) + C2 (중간 상세도) 혼합
- 각 레벨별 부분 답변 생성 후 메타-리듀서로 최종 합성
→ 커버리지와 상세도 동시 확보논문에서 다룬 정적 인덱싱을 갱신하는 경우의 설계 과제
(현재 GraphRAG 구현 전체가 증분 갱신을 지원하지 않는다는 뜻은 아님)
개선안:
- 새 청크 → 엔티티 추출 → 기존 그래프에 merge
- 영향받은 커뮤니티만 재탐지 (delta 커뮤니티 업데이트)
- 변경된 커뮤니티 요약만 재생성
→ 실시간/준실시간 코퍼스 업데이트 지원현재 한계:
- LLM-as-a-Judge의 stochasticity → 5회 반복 평균으로 완화했지만 근본 해결 아님
- 두 LLM이 같은 편향을 공유할 경우 체계적 오류 가능
개선안:
1. 인간 평가 서브셋으로 LLM 평가 보정 (calibration)
2. 여러 LLM 패밀리로 교차 평가 (GPT-4 + Claude + Gemini)
3. 도메인 전문가 평가 도입 (특히 의료/법률 등 고위험 도메인)
4. RAGAs 스타일 자동 지표와 병행 측정운영 비용 최적화 우선순위:
1순위: C0 레벨 우선 검토 (논문 평가 조건에서 SS보다 높은 포괄성·다양성, 97% 토큰 절감)
실제 운영 데이터에서는 품질과 비용을 다시 비교
2순위: Self-reflection 횟수별 추출 품질과 비용을 비교해 선택
3순위: MAP 단계 완전 비동기 병렬화 (latency 핵심)
한국어 도메인 적용 시 추가 고려사항:
- 형태소 분석 기반 청킹과 토큰 기반 청킹의 추출 품질을 별도 비교
(이 논문은 한국어 품질 향상을 검증하지 않음)
- 한국 고유명사(조직/인물) few-shot 예시의 필요성과 효과를 평가
- LLM 프롬프트 한국어 직접 작성 vs 영어 번역 후 처리 성능 비교 필요참고 자료
수치와 평가 조건은 논문 v2의 4.1.3·5.1절 및 부록 A·C (https://arxiv.org/html/2404.16130v2 (새 창))를 함께 참조한다.
From Local to Global: A Graph RAG Approach to Query-Focused Summarization — Microsoft Research (https://www.microsoft.com/en-us/research/publication/from-local-to-global-a-graph-rag-approach-to-query-focused-summarization/ (새 창))