프롬프트 20%가 학습 토큰 2%가 되는 이유: MOPD의 길이 불균형
MOPD에서 프롬프트 배정 비율과 학습 토큰 비중이 달라지는 이유를 계산한다. TRL의 교사 라우팅·손실 분모·토큰 집계 코드를 따라가며 데이터 재추출과 손실 가중의 차이를 설명한다.
수학·코드·지시 따르기 데이터를 40:40:20으로 섞었다고 해서, 학습 손실에서도 세 분야가 그 비율만큼 비중을 차지하는 것은 아니다. 답변 길이가 다른 상태에서 손실을 토큰 단위로 평균 내면, 긴 답변을 만드는 분야가 더 많은 항을 보탠다. 짧은 답변을 요구하는 지시 따르기는 프롬프트의 20%를 배정받아도 실제 학습 토큰에서는 몇 퍼센트에 그칠 수 있다.
여러 교사 모델의 능력을 한 학생 모델로 옮기는 MOPD에서도 같은 문제가 생긴다. TRL을 사용한 MOPD 소개 (새 창)의 교사별 그래프와 공개 구현을 바탕으로, 프롬프트 배정부터 손실 집계까지의 과정을 따라가 본다. 아래 숫자 계산은 원리를 설명하기 위한 가상 배치이며, 학습을 직접 실행한 결과는 아니다.
교사에게 가는 것은 새 정답 요청이 아니라 학생의 답변이다
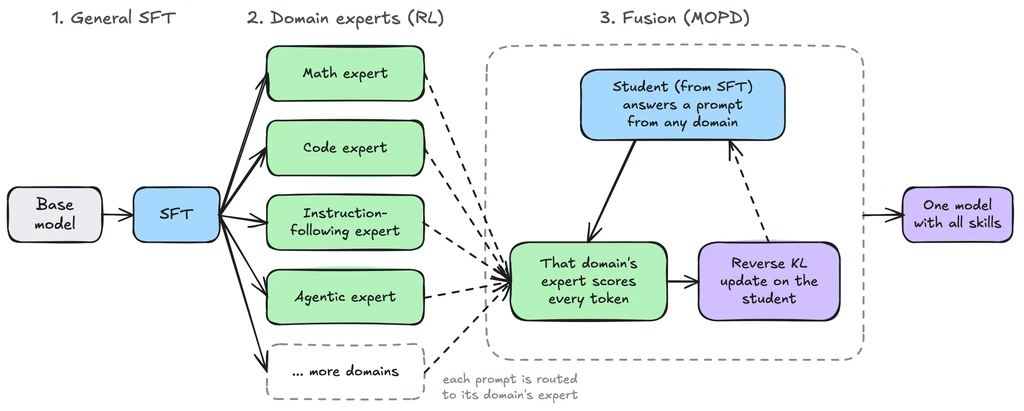
Async Distillation 문서 (새 창)를 보면 학생은 먼저 프롬프트를 받아 답변을 생성한다. 이어서 해당 분야의 교사가 학생이 만든 토큰열을 평가하고, 학생의 분포가 교사 쪽에 가까워지도록 학습이 진행된다. 교사가 완성한 답을 미리 모아 학생에게 보여 주는 방식과 달리, 학생이 실제로 생성한 경로에서 피드백을 받는다는 점이 on-policy의 핵심이다.
공개 예제 (새 창)는 데이터의 domain 열을 teacher_id로 바꾼다. math·code·if 값이 각각 teacher_server_urls에서 해당 교사의 주소를 고른다. 프롬프트 하나를 세 교사에게 모두 보내 평균을 내는 방식이 아니다. 따라서 if 예제가 토큰을 적게 만들었다고 해서 수학 교사가 그 부족분을 대신 가르쳐 주지도 않는다.
이 방식에서는 교사와 학생이 같은 토크나이저를 써야 한다. 문서에 따르면 교사에게 전달하는 값은 원문 문자열이 아니라 토큰 ID이고, 돌려받는 후보 ID도 학생의 어휘에 직접 대응한다. 같은 숫자가 서로 다른 단어를 뜻한다면 비교 기준부터 어긋난다. 여기서는 동일한 모델 계열에서 출발한 교사들을 결합하는 상황을 전제로 한다.
100개 답변을 세면 20%, 토큰을 세면 1.64%다
수학 40개, 코드 40개, 지시 따르기 20개의 답변이 있다고 하자. 학습 대상 답변 길이를 각각 2,000·4,000·200토큰으로 가정하면 수학은 80,000토큰, 코드는 160,000토큰, 지시 따르기는 4,000토큰을 만든다. 합계는 244,000토큰이다.
지시 따르기의 예제 비중은 20/100=20%지만, 토큰 비중은 4,000/244,000≈1.64%에 불과하다. 데이터 라우팅에 오류가 있어서 생기는 차이가 아니다. 모든 예제가 올바른 교사에게 전달되었더라도 순전히 답변 길이 차이만으로 이만큼 벌어진다. 분야별 예제 수에 평균 학습 토큰 수를 곱한 뒤 전체 합계로 나누면 같은 방식으로 계산할 수 있다.
다만 1.64%라는 수치를 기울기 영향력이나 능력 향상률로 바로 해석해서는 안 된다. 토큰마다 손실과 기울기 크기가 다르고, 학습이 진행되면서 답변 길이도 변하기 때문이다. 이 계산이 보여 주는 것은 토큰 평균 손실에 들어가는 항의 개수뿐이다. 모델이 지시를 얼마나 잘 따르게 되었는지는 별도의 평가 문제로 확인해야 한다.
예제의 40:40:20 역시 모든 작은 배치에서 개수가 정확히 이 비율대로 맞아떨어진다는 뜻은 아니다. 공개 코드는 이 값을 interleave_datasets의 추출 확률로 사용한다. 위 예시의 100개 배치는 비율과 길이의 관계를 분명하게 보여 주기 위해 개수를 고정해 계산한 것이다.
코드는 예제 수가 아니라 학습 토큰 수로 나눈다
고정 버전의 학습 구현 (새 창)은 completion_mask의 합으로 학습 대상 토큰 수를 센다. 프롬프트를 포함해 모델이 읽은 전체 토큰 수는 따로 기록한다. 따라서 긴 입력 문서를 읽었다는 이유만으로 그 입력 전체가 교사별 손실 비중에 반영되지는 않는다.
손실 계산 (새 창)은 유효한 위치의 손실을 모두 더한 뒤 global_n_tokens를 이용해 정규화한다. 분산 학습에서는 프로세스 간 기울기 평균을 보정하고 gradient accumulation도 반영하지만, 각 분야의 답변 하나를 먼저 같은 비중으로 평균 내는 구조는 아니다. 위 가상 배치의 경우라면 짧은 지시 따르기 답변은 적은 수의 토큰 항만 보탠다.
teacher_token_frac 집계 (새 창)는 교사별 유효 토큰 수와 전체 토큰 수를 각각 분자와 분모에 누적해 기록한다. 크기가 다른 작은 배치들의 비율을 단순 평균 내지 않도록 한 구현이다. 예를 들어 한 배치에서 1/10, 다른 배치에서 45/90을 얻었다면 전체 비율은 46/100=46%가 된다. 두 배치의 비율인 10%와 50%를 단순 평균 낸 30%와는 다르다. 배치 크기를 무시한 평균이 아니라 실제 토큰의 총합을 기준으로 비중을 읽을 수 있다.
분모 계산에도 예외는 있다. 코드 주석을 보면 교사의 유효 신호가 없는 위치를 손실 계산에서 제외하더라도 global_n_tokens는 여전히 completion_mask 기준으로 남는다. 이처럼 신호가 누락되면 손실 정규화의 분모와 교사별로 실제 점수를 받은 토큰 수가 완전히 일치하지 않는다. 위 1.64% 계산은 교사 신호가 모두 정상이라는 가정 아래 설명한 것이다.
위쪽 면적은 토큰 비중이고 아래쪽 선은 교사와의 차이다
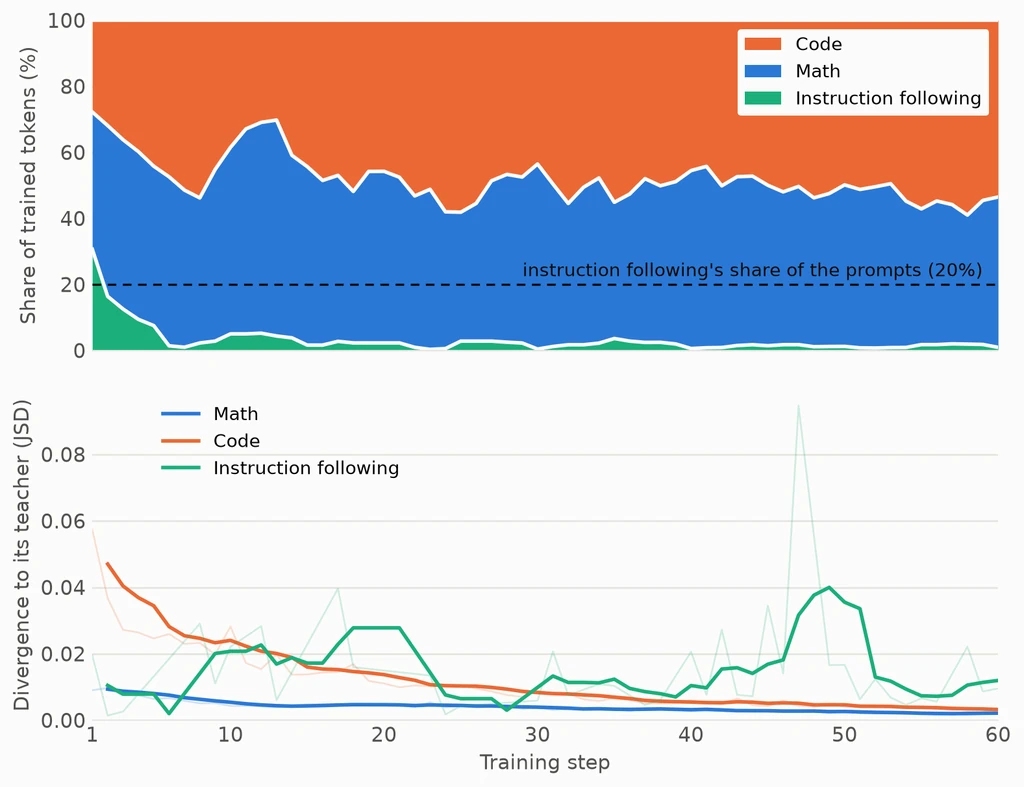
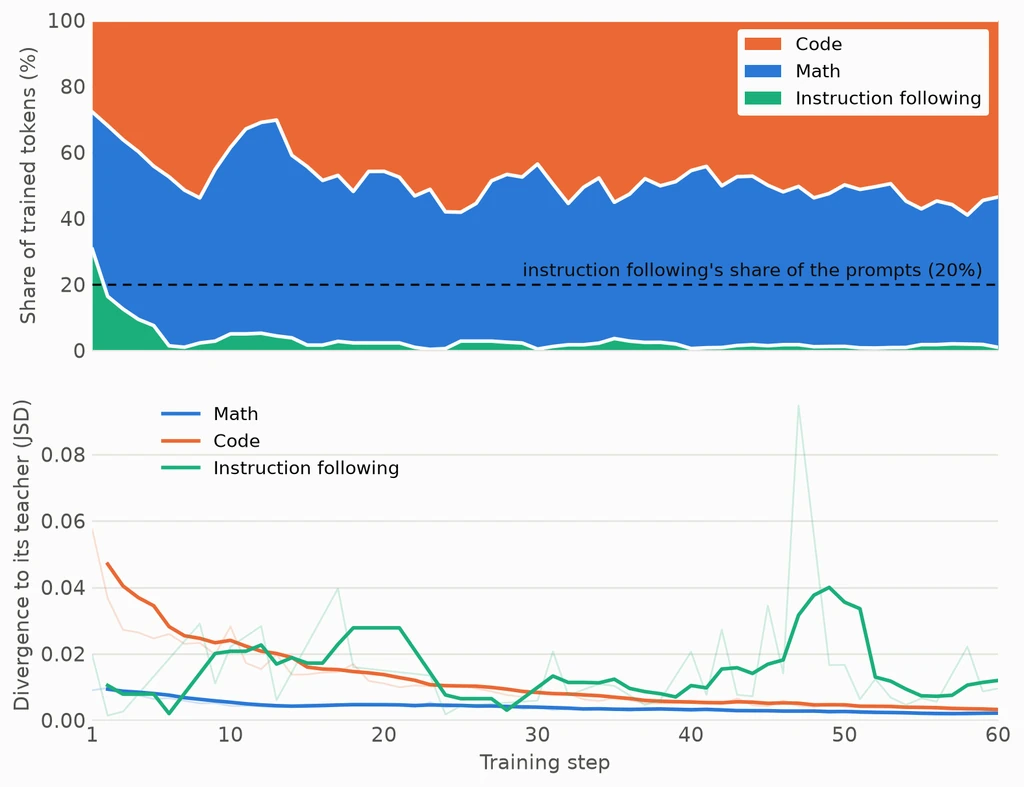
아래는 공식 글에 실린 60스텝 실험의 그래프다. 위쪽 그래프의 점선은 지시 따르기 프롬프트의 배정 비율인 20%를 나타내고, 초록 면적은 실제 학습 토큰 비중을 보여 준다. 초반 이후 초록 면적이 좁아지는 모습에서 두 비율이 같지 않음을 알 수 있다. 주황은 코드, 파랑은 수학이다.
아래쪽 그래프는 teacher_jsd 지표이며 진한 선은 5스텝 이동평균이다. 공식 캡션에서는 지시 따르기의 토큰 비중이 1~3%에 그친다고 설명한다. 수학·코드의 선은 내려가는 반면 초록 선은 같은 추세를 보이지 않는다. 다만 이 그림만으로 토큰 비중이 성능 차이의 유일한 원인이라고 단정할 수는 없다. 교사와 가까워지는 정도와 실제 과제 정답률 역시 서로 다른 측정값이다.
현재 예제 코드의 max_steps는 90이지만, 이 그림은 소개 글에서 보고한 60스텝 실험 결과다. 예제 코드의 설정값을 그림의 측정 기간으로 혼동해 읽지 않는다. 또한 teacher_jsd라는 이름만 보고 언제나 같은 형태의 발산을 계산한다고 가정해서도 안 된다. 문서는 beta 설정에 따라 목적함수가 달라진다고 설명한다. 서로 다른 설정의 곡선을 비교할 때는 지표 이름뿐만 아니라 설정값도 맞춰야 한다.
짧은 분야를 더 뽑는 것과 손실을 다시 가중하는 것은 다르다
앞의 가상 배치에서 수학·코드 80개를 유지한 채 지시 따르기의 토큰 비중을 20%로 맞추려면 어떻게 해야 할까. 짧은 답변을 300개로 늘리면 60,000토큰이 되어 전체 300,000토큰 중 20%를 차지한다. 이때 전체 예제 수는 380개이고 지시 따르기가 약 78.95%를 차지한다. 단순히 프롬프트 비율을 조금 높이는 것만으로 충분하다고 보기 어려운 이유다. 물론 이 숫자는 고정 길이를 가정한 산술 결과일 뿐 권장 혼합 비율이 아니다.
예제를 더 많이 뽑으면 학생의 생성과 교사의 평가 작업도 그만큼 늘어난다. 같은 짧은 예제를 반복해서 뽑는다면 학습하는 내용의 다양성이 그만큼 늘어나는 것도 아니다. 반면 분야별 토큰 평균 손실을 먼저 구한 뒤 그 평균들을 40:40:20으로 합치는 설계를 생각해 볼 수 있다. 이 경우 지시 따르기는 예제 길이에 상관없이 20%의 결합 계수를 갖지만, 적은 토큰에서 나온 평균에 더 큰 무게를 실어 주게 될 수 있다. 이는 두 정규화 방식의 차이를 설명하기 위한 대안일 뿐, 현재 예제에 적용된 구현이나 검증된 개선책은 아니다.
내가 이 예제를 확장한다면 우선 데이터의 추출 비율, 교사별 학습 토큰 비중, 분야별 평가 결과를 함께 기록할 것이다. 짧은 답변이 실제로 적게 학습되는 문제인지 확인한 뒤 데이터 재추출과 손실 가중 중 어디를 바꿀지 고를 수 있다. 또한 학습 중 답변 길이가 달라지면 같은 설정이라도 토큰 비중을 다시 확인한다. 20%라는 숫자를 유지하는 것보다, 무엇을 세어 만든 20%인지 구분하는 일이 먼저다.