자연어 기반 SQL 생성·검증
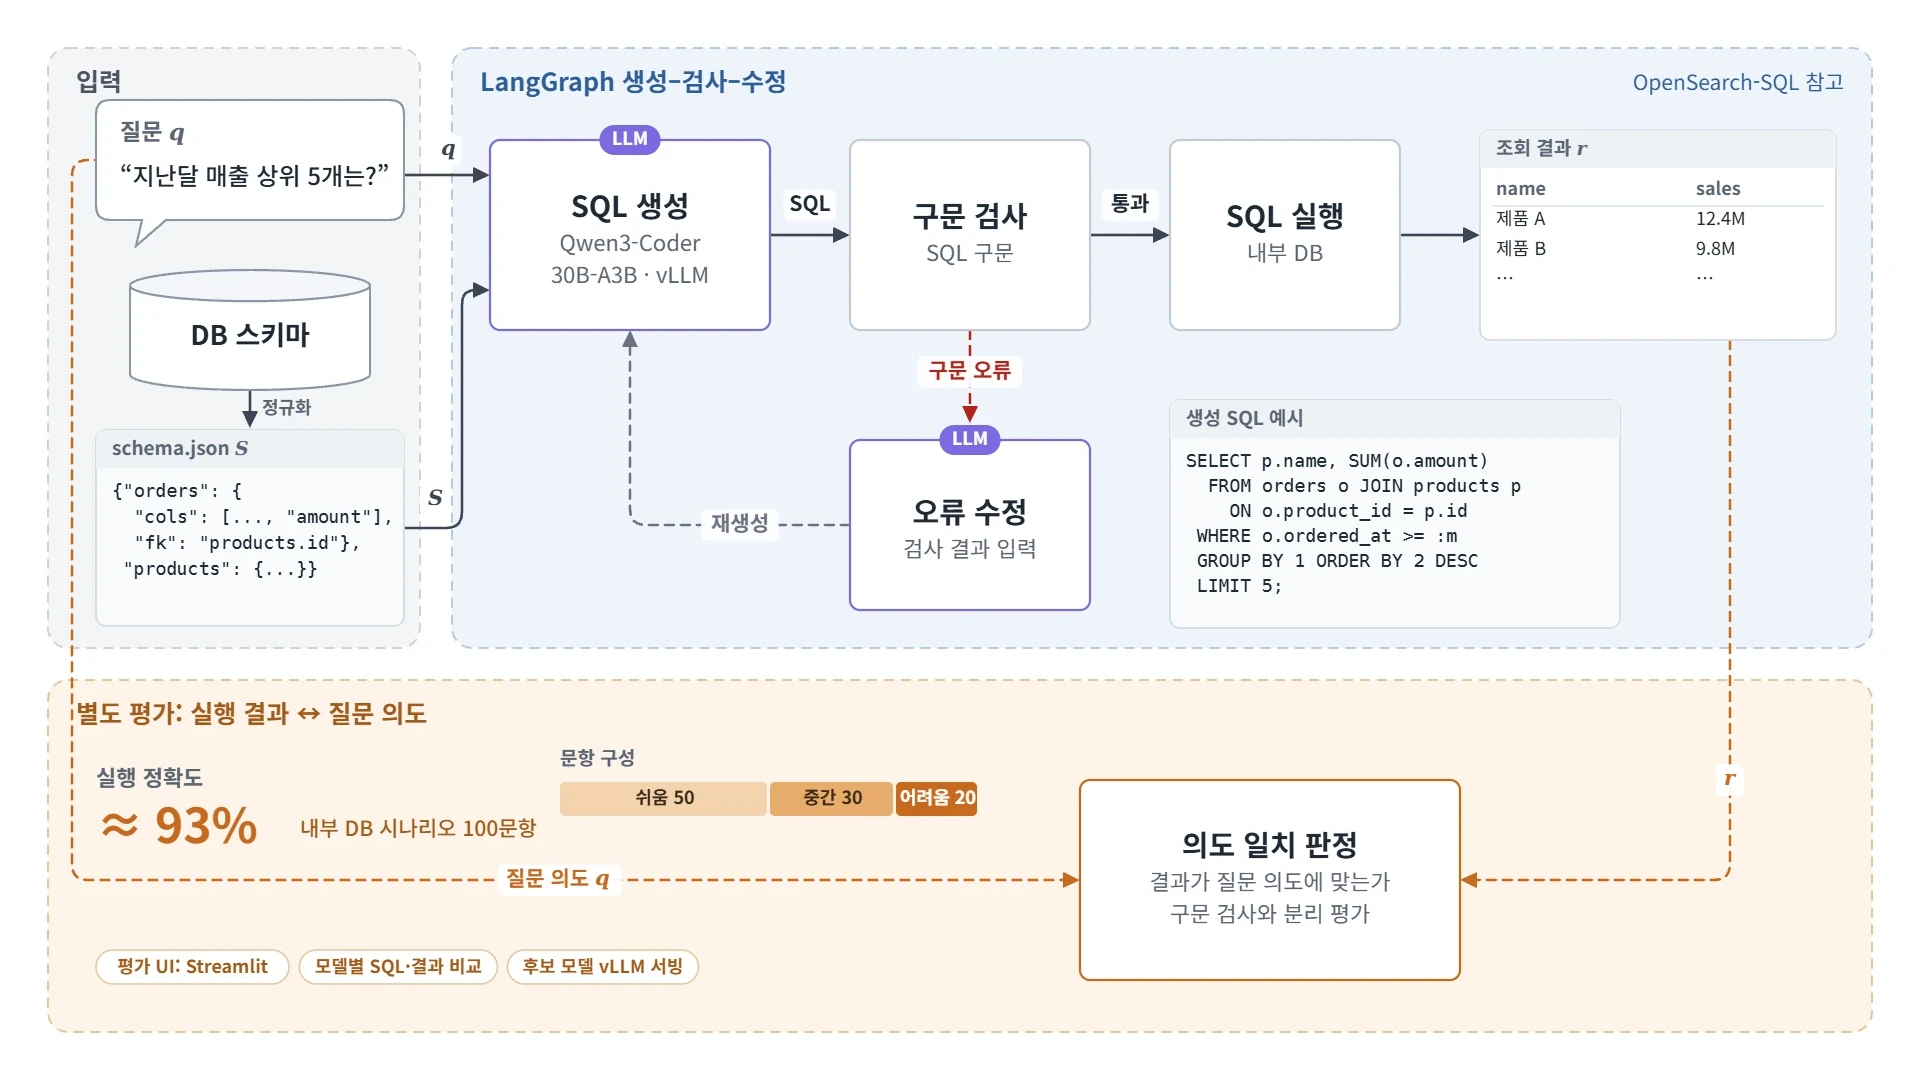
자연어 질문을 SQL로 변환하는 흐름을 구현했습니다. DB 스키마 정리부터 SQL 생성·검사·수정까지 연결하고, 실행 결과가 기대한 결과와 맞는지 평가했습니다.
- 기간
- 2025.07 ~ 2025.11
- 담당
- 스키마 정리, SQL 생성·검사·수정 흐름, 모델 서빙, 실행 결과 비교·평가 화면 구현
- 결과
- 내부 100문항 시나리오 실행 정확도 약 93% (Qwen3-Coder-30B-A3B)
과제와 구현 범위
자연어 질문으로 데이터베이스를 조회할 수 있도록 SQL 생성·검사·수정 흐름을 구현했습니다. 모델별 생성 SQL과 실제 조회 결과를 함께 확인하는 화면도 만들었습니다.
생성 과정의 SQL 구문 검사와 최종 조회 결과의 평가는 나누었습니다. 실행 정확도는 생성한 SQL을 실행했을 때 기대한 결과를 얻은 비율로 정의했습니다.
설계 판단
구문 검사를 통과한 SQL도 틀린 결과를 반환할 수 있습니다. 예를 들어 조인 중복으로 행이 늘어나면 매출이 부풀려집니다. 그래서 생성 과정의 구문 검사와 최종 평가를 분리하고, 평가 기준을 실행 결과로 정했습니다.
모델은 실행 정확도가 더 높은 Qwen3-Coder-30B-A3B(약 93%)를 선택했습니다. Qwen3-8B는 약 60%였습니다.
스키마 정리와 생성·수정 흐름
DB 스키마와 테이블 정의서를 JSON으로 정리해 모델 입력에 사용했습니다. OpenSearch-SQL 논문을 참고하고, LangGraph로 SQL 생성, 구문 검사, 오류 수정 단계를 연결했습니다.
vLLM으로 후보 모델을 서빙했습니다. Streamlit 화면에서 모델별 생성 SQL과 실행 결과를 비교하고, 조회 결과가 질문의 의도에 맞는지 별도로 평가했습니다.
100문항 내부 평가와 결과
Qwen3-Coder-30B-A3B와 Qwen3-8B를 내부 DB 시나리오 100문항으로 비교했습니다. 문항은 쉬움 50개, 중간 30개, 어려움 20개로 구성했습니다.
Qwen3-Coder-30B-A3B의 실행 정확도는 약 93%, Qwen3-8B는 약 60%였습니다.
이 생성·검사·수정 흐름은 이후 다른 프로젝트에도 적용했습니다.