LLM·멀티모달 임베딩 GPU 서빙
LLM과 임베딩 모델을 API로 제공하는 서빙 환경을 구축했습니다. 인증·요청 라우팅·추론·모니터링을 연결하고, 요청 부하와 장문 입력, 답변 품질을 각각 검증했습니다.
- 기간
- 2026.08 ~ 2026.10
- 담당
- 서빙·API 구성, 런타임 분석·튜닝, 평가셋 구성, 배포·모니터링·복구 구현
- 결과
- Gemma 4 31B-it 복제본당 동시 16개에서 1,165 tok/s, 256K 문맥 검증
과제와 구현 범위
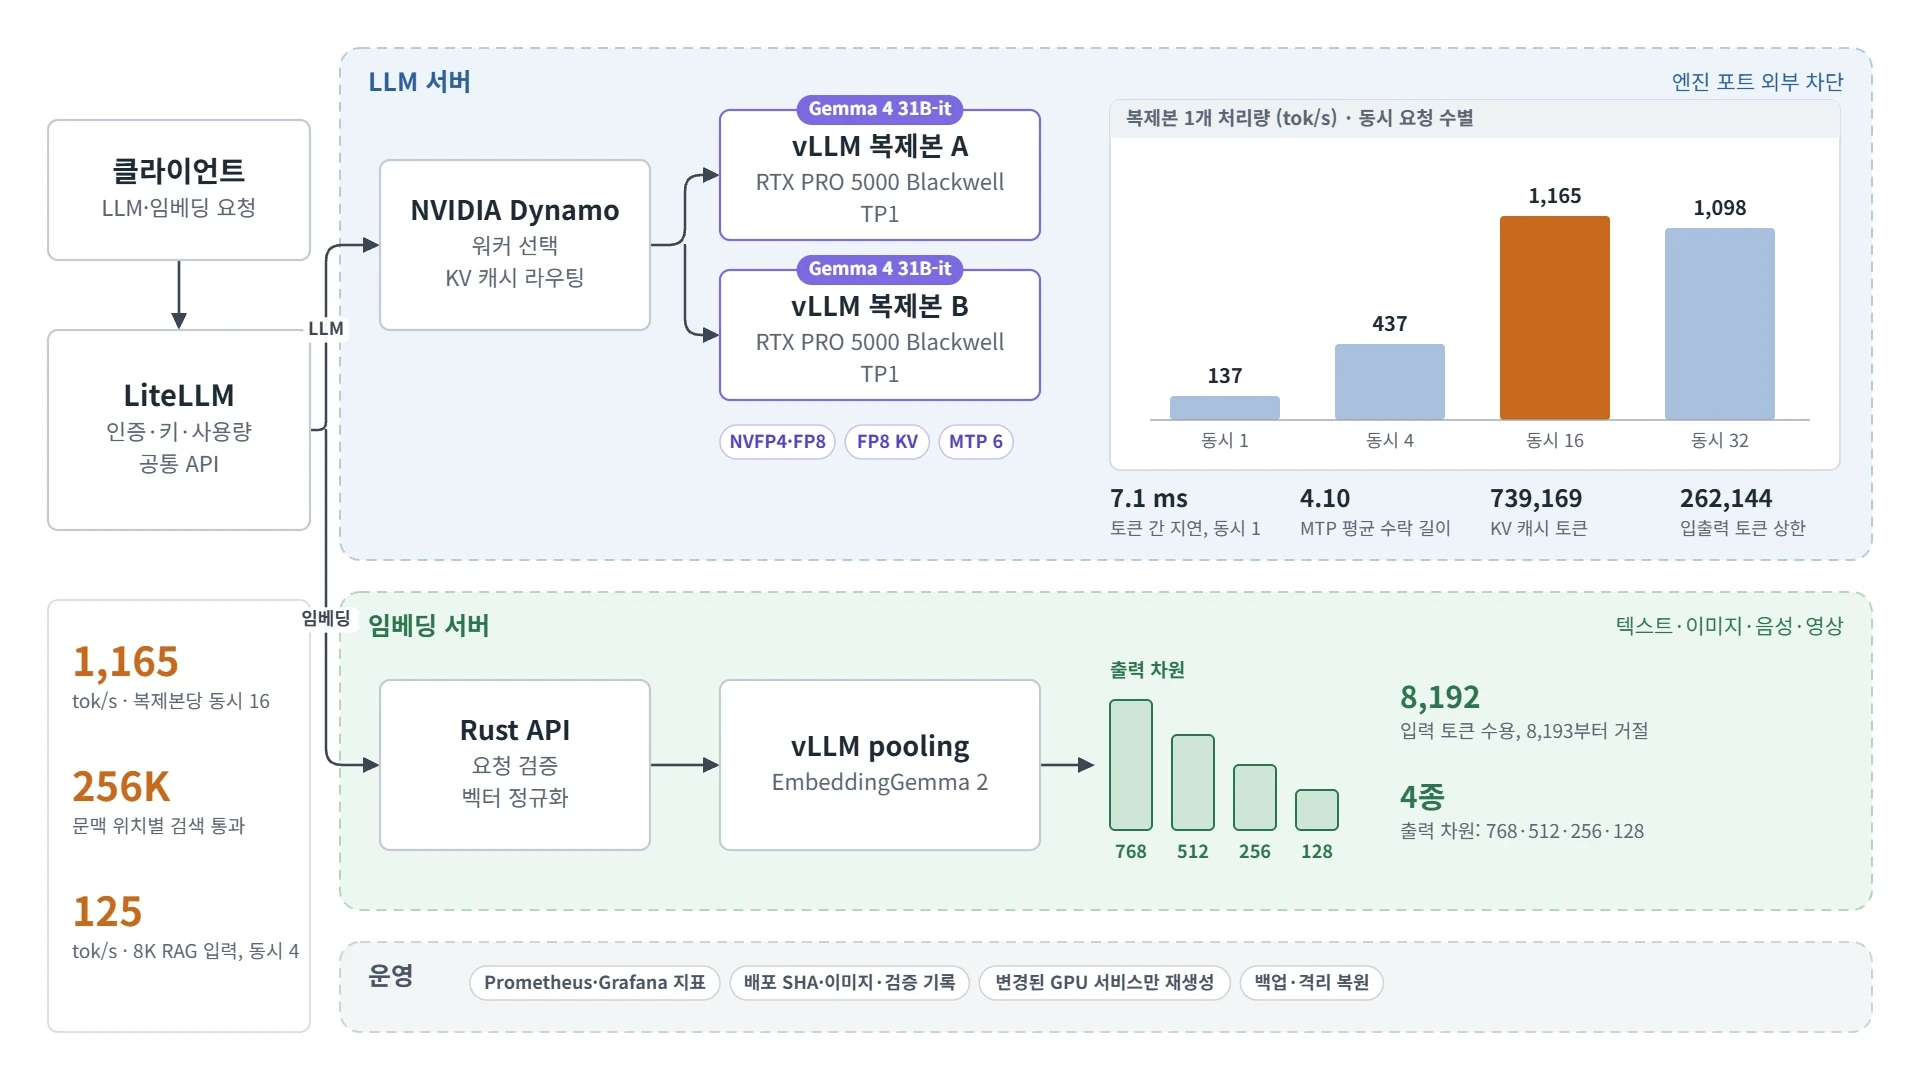
LLM 응답 생성과 멀티모달 임베딩을 API로 제공하고, 요청이 늘어날 때의 동작을 확인하는 서빙 환경을 구축했습니다. 두 모델군을 별도 서버로 분리하고 인증부터 요청 라우팅, GPU 추론, 모니터링까지 연결했습니다.
LLM(Gemma 4 31B-it)은 RTX PRO 5000 Blackwell GPU마다 모델을 하나씩 올리는 TP1 복제본 두 개로 구성했습니다. 처리량·지연시간 측정, 장문 입력 검사, 답변 품질 평가는 서로 다른 시험으로 진행했습니다.
설계 판단
동시 요청 16개에서 처리량이 가장 높았고(1,165 tok/s), 32개에서는 오히려 줄었습니다(1,098 tok/s). 그래서 복제본당 동시 요청 16개를 운영 기준으로 정했습니다.
LLM과 임베딩은 요청 특성이 달라 서버를 분리했습니다.
요청 처리와 배포 구성
LiteLLM에서 인증·키·사용량을 관리하고, NVIDIA Dynamo 1.6.0에서 요청을 처리할 워커를 선택하고 KV 캐시를 고려해 라우팅하도록 구성했습니다. GPU 추론에는 vLLM 0.31을 사용했습니다.
LLM에는 MLP NVFP4·attention FP8 체크포인트, MTP 깊이 6, FP8 KV 캐시, FP8 projection CUTLASS 커널을 적용했습니다. 모델 설정은 프로필 파일로 분리해 GPU별로 지정할 수 있게 했습니다. 공개 모델 목록은 Dynamo에 등록된 모델을 기준으로 생성하고, 배포할 때는 변경된 GPU 서비스만 재생성하도록 했습니다.
임베딩 서버는 EmbeddingGemma 2와 vLLM pooling으로 텍스트·이미지·음성·영상을 처리하도록 구성했습니다. Rust API에서 요청을 검증하고 768·512·256·128차원 출력 벡터를 정규화했습니다.
추론 엔진 포트는 외부에서 직접 접근하지 못하도록 차단했습니다. Prometheus·Grafana로 지표를 수집하고, 배포 SHA와 실행 이미지, 검증 기록을 연결했습니다. 백업과 격리 환경에서의 복원 절차도 구현했습니다.
부하 시험과 장문 입력 검사
부하 시험에서는 GPU 복제본 하나를 기준으로 동시 요청 수를 바꾸었습니다. 대화 처리량은 동시 요청 1개에서 137 tok/s, 4개에서 437 tok/s, 16개에서 1,165 tok/s, 32개에서 1,098 tok/s였습니다. tok/s는 초당 처리한 토큰 수입니다. 동시 요청 1개의 토큰 간 지연은 7.1ms였고, 8,000토큰 RAG 입력 시험은 동시 요청 4개에서 125 tok/s를 기록했습니다.
장문 입력은 별도로 검사했습니다. 32K·128K·256K 입력의 앞·중간·끝에 배치한 정보를 찾는 검사를 통과했습니다.
입력 한계에서는 LLM의 입력·출력 합계 262,144토큰 경계와 이를 초과한 요청의 HTTP 400 응답을 확인했습니다. 임베딩은 8,192토큰을 수용하고 8,193토큰을 거절하는지 검사했습니다.
MTP 평균 수락 길이는 4.10이었고, KV 캐시 용량은 739,169토큰이었습니다.
기본 검사 48개와 합성 품질 패널 512문항을 통과했습니다. 임베딩의 네 출력 차원, float/base64 응답, 벡터의 유한성·정규화·기준 유사도, 인증·TLS도 검사했습니다.
공개 데이터로 구성한 답변 품질 평가
외부 공개 데이터셋에서 어려운 문항 300개를 고정된 시드로 추출했습니다. 같은 문항으로 다시 평가할 수 있도록 문항 ID와 SHA256을 보관했습니다.
API 응답을 평가한 결과 300문항 중 178문항이 정답이었습니다.
| 영역 | 데이터셋 | 정답 |
|---|---|---|
| 한국어 | KoBALT 3단계 | 20/50 |
| 제조 | KMMLU-Redux 기계·재료·안전관리·전기전자 | 34/50 |
| 일반화 | BIG-Bench Extra Hard | 32/50 |
| 추론 | GPQA Diamond, AIME 2026 | 37/50 |
| 지시 | IFBench, IFEval-Ko | 25/50 |
| 도구 호출 | BFCL multiple·parallel | 30/50 |
| 합계 | 178/300 |