PreHypo: 두 유형의 가상질문과 사전 청크 그래프를 활용한 금융 문서 질의응답
표·본문·주석에 나뉜 금융 문서의 근거를 두 유형의 가상질문과 사전 청크 그래프로 연결한 연구입니다. FinanceBench 150문항에서 비교 방법 중 가장 많은 48문항에 정답을 제시했고, ACK 2026 우수논문상을 받았습니다.
- 기간
- 2026.03 ~ 2026.11
- 담당
- 제1저자·구두 발표자 (공동저자: 김기용, 김찬우)
- 결과
- FinanceBench 150문항에서 정답 48개로 비교 방법 중 최다 · ACK 2026 우수논문상
표·본문·주석에 나뉜 근거를 함께 찾기
금융 공시의 질문에 답하려면 재무 수치뿐 아니라 회계기간과 비교 기준도 함께 찾아야 합니다. SEC 10-K·10-Q에서는 이런 근거가 표, 본문, 주석에 나뉘어 있어 한 청크만 검색하면 답변에 필요한 맥락을 놓칠 수 있습니다.
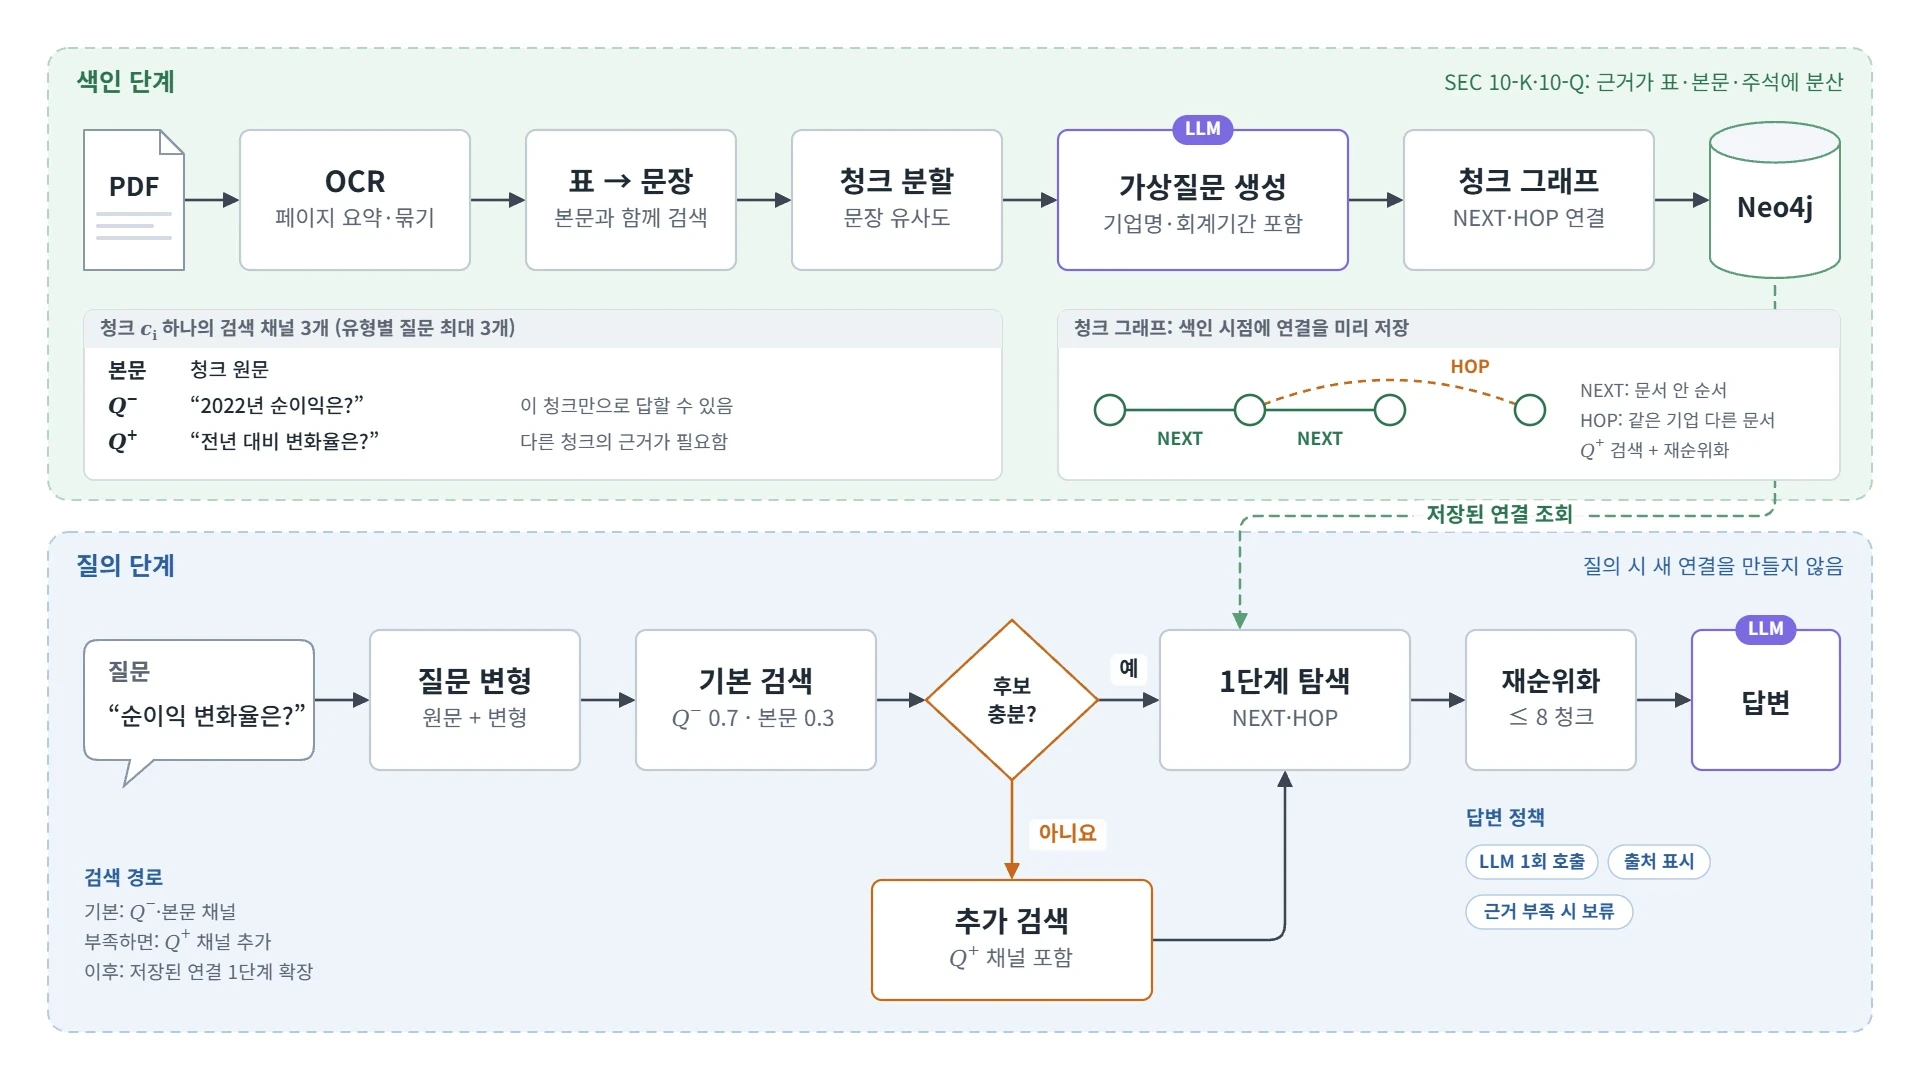
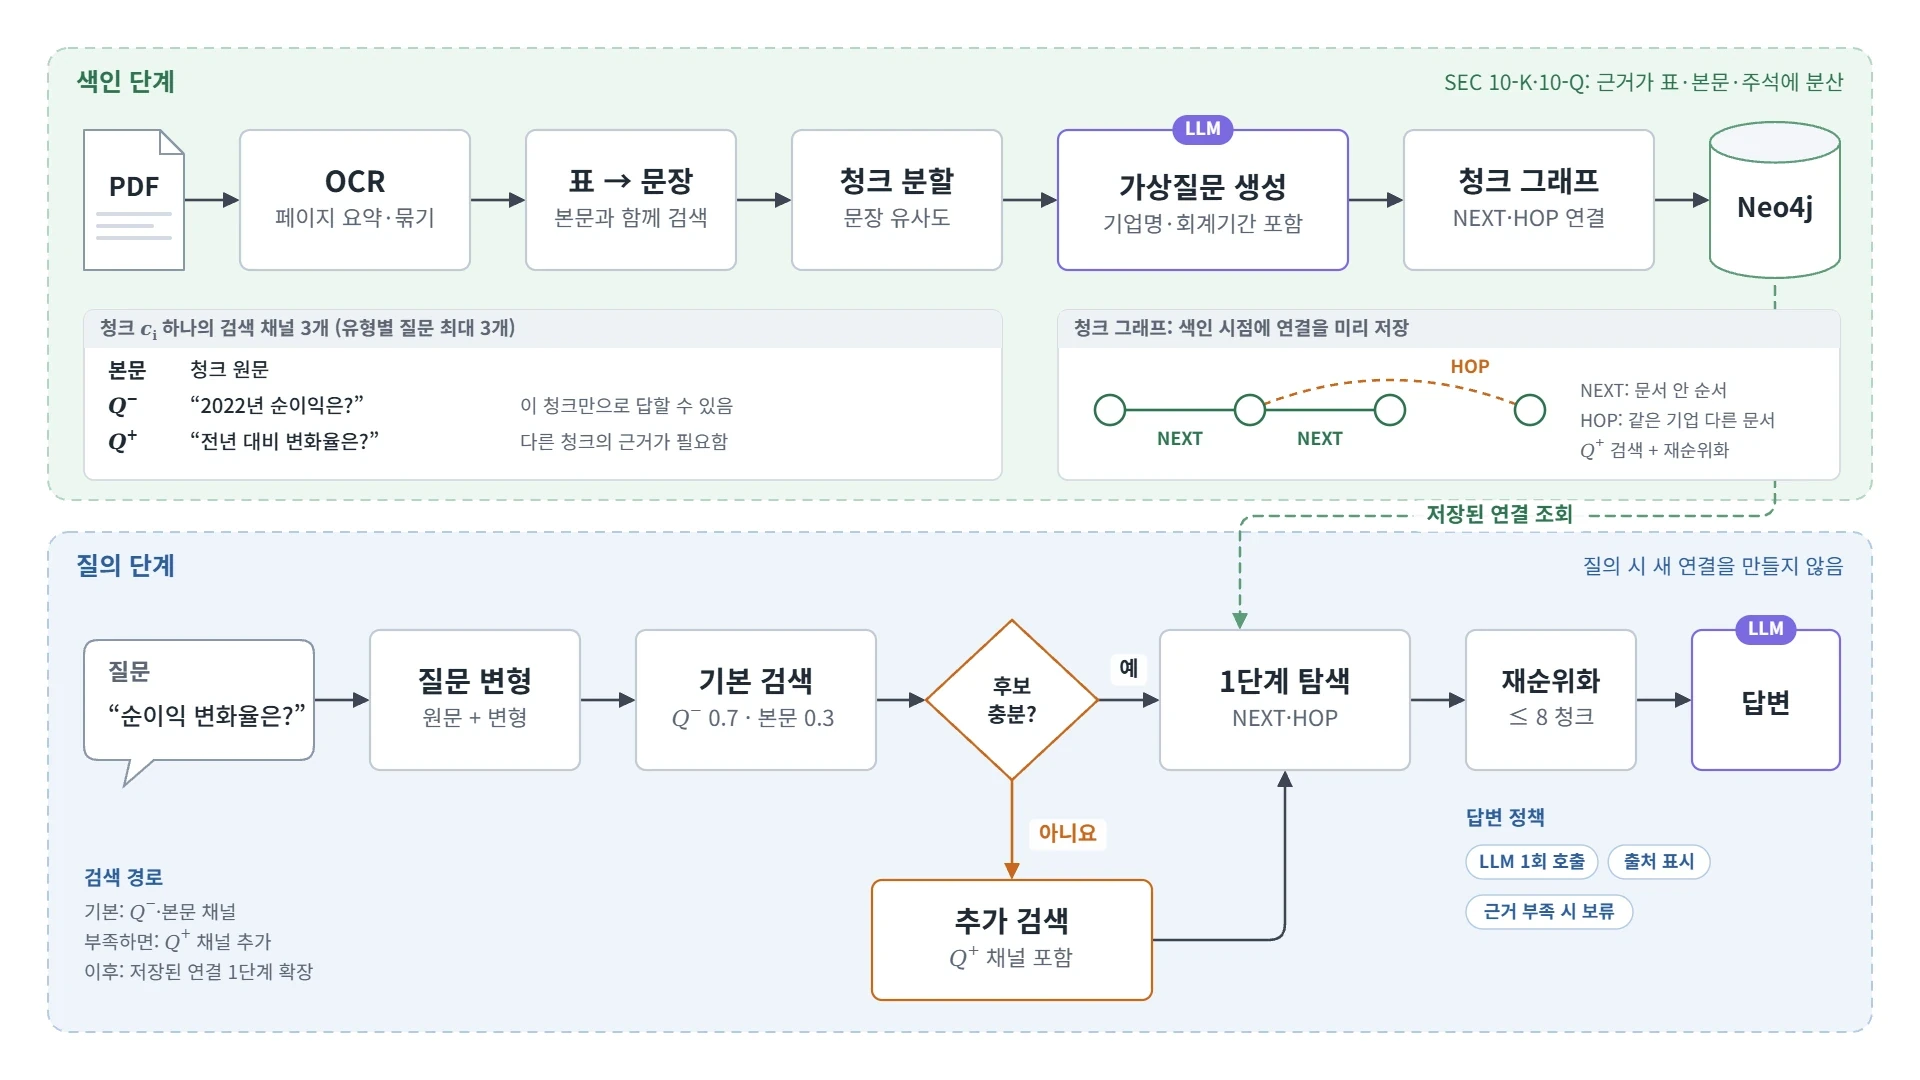
PreHypo는 청크마다 두 유형의 가상질문을 만들고, 추가 근거가 있는 청크와의 연결을 색인 단계에 미리 저장하는 금융 문서 질의응답 방법입니다. 표를 문장으로 바꿔 본문과 함께 검색하고, 질문에 맞는 근거를 저장된 그래프에서 확장합니다.
두 유형의 가상질문과 청크 그래프
Q⁻는 해당 청크만으로 답할 수 있는 질문입니다. “2022년 순이익은?”처럼 직접 근거를 찾는 데 사용합니다. Q⁺는 “전년 대비 변화율은?”처럼 다른 청크의 근거도 필요한 질문입니다. 기업명과 회계기간을 포함한 질문을 유형별로 최대 3개 만들고, 청크 본문·Q⁻·Q⁺를 별도 검색 채널에 저장합니다.
청크 그래프에는 문서 안의 순서를 나타내는 NEXT 연결과 추가 근거를 잇는 HOP 연결을 둡니다. HOP 후보는 같은 기업의 다른 문서에 속한 청크로 제한합니다. Q⁺를 이용해 후보를 검색하고 재순위화한 뒤 연결을 저장합니다. 질의 시점에는 새 연결을 만들지 않고 저장된 연결을 한 단계 탐색합니다.
색인과 질의 처리
색인 단계에서는 PDF를 문자 인식한 뒤 페이지를 요약하고, 인접 페이지의 내용을 묶습니다. 표를 문장으로 변환하고 문장 유사도에 따라 청크를 나눈 다음 가상질문과 NEXT·HOP 연결을 구성합니다. 검색 표현과 그래프는 Neo4j에 저장합니다.
질의 단계에서는 사용자 질문과 변형 질문을 사용해 Q⁻·본문 채널을 먼저 검색합니다. 후보 수나 점수가 기준에 못 미치면 Q⁺ 채널을 포함한 추가 검색을 수행합니다. 이어 NEXT·HOP 연결을 한 단계 탐색하고 재순위화해 최대 8개 청크를 답변 생성에 전달합니다. 답변 생성은 LLM 1회 호출로 수행하며, 출처를 표시하고 근거가 부족하면 답변을 보류하도록 구성했습니다.
공개 구현의 기본 설정은 Q⁻ 0.7·본문 0.3의 기본 검색, Q⁺ 0.6·Q⁻ 0.4의 조건부 추가 검색입니다. 벡터 검색과 전문 검색 결과는 가중 RRF로 통합합니다.
FinanceBench 150문항에서 비교
FinanceBench의 공개 질의 150개로 PreHypo, HopRAG, MS-GraphRAG, Naive RAG를 비교했습니다. 모든 방법에 같은 답변 생성 모델과 임베딩 모델을 사용했습니다. 평가 모델은 질의와 기준 답변을 바탕으로 최종 답변을 판정했고, 표시 단위가 달라도 실제 값이 같으면 정답으로 인정했습니다.
결과의 평균±표준편차는 30문항씩 나눈 5개 집합을 기준으로 집계했습니다(seed 42). 실험에 사용한 모델은 다음과 같습니다.
| 역할 | 모델 |
|---|---|
| 문서 인식 | LightOnOCR-1B-1025 |
| 답변 생성 | Qwen3-4B-Instruct-2507 |
| 임베딩 | Qwen3-Embedding-0.6B |
| 재순위화 | Qwen3-Reranker-0.6B |
| 평가 판정 | gpt-5.5-2026-04-23 |
정답 수와 환각률을 함께 비교
PreHypo는 150문항 중 48개에 정답을 제시했습니다. 비교 방법의 정답 수는 HopRAG 29개, MS-GraphRAG 28개, Naive RAG 8개였습니다. 정답률 J는 0.32±0.07, 조건부 정답률 J|Att는 0.59±0.12, 페이지 일치율 PgM은 0.19±0.07입니다.
정답률과 페이지 일치율은 이 실험의 비교 방법 중 가장 높았지만, 환각률 H는 0.17±0.08로 HopRAG(0.13±0.04)와 Naive RAG(0.04±0.01)보다 높았습니다. 정답을 더 많이 찾은 결과와 잘못된 답변을 줄여야 하는 과제를 함께 확인했습니다.
| 방법 | 정답 수 | 정답률 J | 조건부 정답률 J|Att | 환각률 H | 페이지 일치율 PgM |
|---|---|---|---|---|---|
| PreHypo | 48 | 0.32±0.07 | 0.59±0.12 | 0.17±0.08 | 0.19±0.07 |
| HopRAG | 29 | 0.19±0.06 | 0.38±0.10 | 0.13±0.04 | 0.04±0.04 |
| MS-GraphRAG | 28 | 0.19±0.05 | 0.24±0.07 | 0.32±0.06 | 0.03±0.04 |
| Naive RAG | 8 | 0.05±0.02 | 0.09±0.02 | 0.04±0.01 | 0.00±0.00 |
검색 구성을 바꿨을 때의 결과
같은 색인을 유지하고 질의 단계의 검색 구성만 바꿨을 때, 전체 설정은 48문항, Q⁻ 단일 검색은 45문항, Q⁺ 단일 검색은 33문항에 정답을 제시했습니다. 전체 설정은 각각 3문항(2%p), 15문항(10%p) 더 맞혔습니다.
단일 검색 설정은 본문 검색과 조건부 추가 검색을 사용하지 않았으며, 모든 설정에서 연결 탐색을 수행했습니다. 따라서 이 비교만으로 청크 그래프 탐색의 효과나 개별 구성 요소의 기여를 분리할 수는 없습니다.
| 검색 구성 | 정답 수 | 정답률 J | 환각률 H |
|---|---|---|---|
| 전체 설정 | 48 | 0.32±0.07 | 0.17±0.08 |
| Q⁻ 단일 검색 | 45 | 0.30±0.07 | 0.17±0.06 |
| Q⁺ 단일 검색 | 33 | 0.22±0.06 | 0.13±0.04 |
한계와 다음 과제
이번 결과는 FinanceBench 150문항, 단일 생성 모델, 1회 실행 기준입니다. 다음 과제는 환각률을 낮추고, 검색 채널과 연결 탐색의 효과를 분리하고, 다른 데이터셋과 모델에서 같은 경향을 확인하는 것입니다.
논문과 수상
한국정보처리학회 ACK 2026에서 발표했고, 우수논문상(2026.10)에 선정됐습니다. 저자는 성연우(제1저자·구두 발표)·김기용·김찬우이며, 소속은 고려대학교 인공지능융합학과입니다.